

Alibaba Qwen lanza Qwen‑Audio‑3.1‑Realtime, full‑duplex 85 % más barato para agentes IA
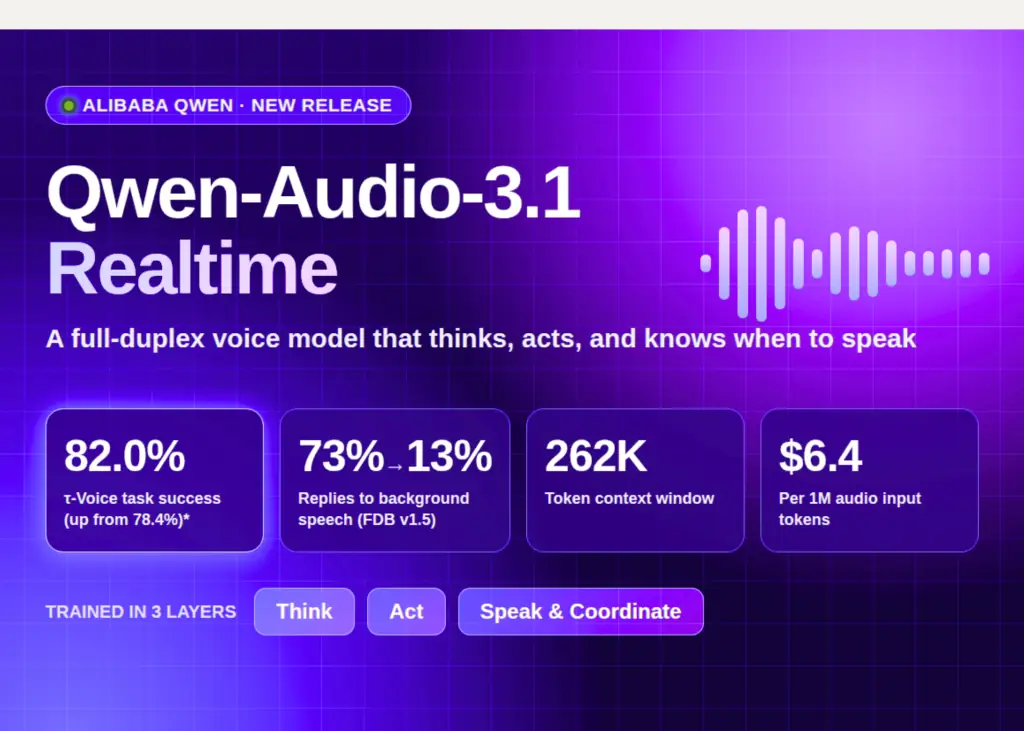
Alibaba Qwen despliega Qwen‑Audio‑3.1‑Realtime, un modelo de voz full‑duplex que reduce los costos de ASR y TTS hasta un 95 % y está disponible como API gestionada en la nube.
Alibaba Qwen ha puesto en producción qwen-audio-3.1-realtime-plus, el modelo central de una pila de cinco componentes que combina reconocimiento de voz (ASR), síntesis de texto a voz (TTS) y capacidades de interacción en tiempo real. El servicio, accesible a través de WebSocket en la plataforma QwenCloud, está pensado para asistentes de voz que necesiten llamar a herramientas externas, como búsquedas web o APIs de terceros.
Detalles del lanzamiento y arquitectura del modelo
La arquitectura se sustenta en dos redes neuronales que comparten el mismo codificador de audio y el mismo diseño de modelo de lenguaje (LLM). Una de ellas actúa como decisor full‑duplex, determinando cuándo el agente debe escuchar, hablar, detenerse o reanudar la conversación. La segunda red transforma la respuesta en texto y, a través de un renderizador de voz sensible al contexto, genera un flujo de audio continuo.
El entrenamiento se organiza en tres capas: Think, Act y Speak & Coordinate. En la fase “Think” se emplea una distilación en política (on‑policy distillation) que alinea el modelo de audio con un LLM de texto mediante datos pareados a gran escala. La capa “Act” incorpora entornos ejecutables donde cada tarea está asociada a un conjunto de herramientas, una base de datos JSON y políticas de negocio expresadas en lenguaje natural. Finalmente, “Speak & Coordinate” decide el momento y la forma de emitir la respuesta, reduciendo los silencios y los solapamientos en conversaciones grupales.
Precios y modelo de negocio una reducción drástica
Alibaba anuncia una caída de precios sin precedentes: hasta un 85 % menos para el modelo en tiempo real, un 70 % para la síntesis de voz y hasta un 95 % para el reconocimiento de audio. Los costos se expresan en tokens, una métrica que permite comparar directamente entrada y salida de texto y audio.
- Entrada de audio: $6.4 por cada millón de tokens.
- Entrada de texto: $0.8 por cada millón de tokens.
- Salida de audio y texto: $24 por cada millón de tokens (la salida de texto no tiene cargo adicional).
- Modelo complementario
qwen-audio-3.1-asr-flash-filetranspara transcripción offline larga: $0.15 entrada y $0.47 salida por millón de tokens.
Los límites por defecto son 60 peticiones simultáneas y 100 000 tokens por minuto, con un contexto máximo de 262 000 tokens (245 000 de entrada y 16 000 de salida). Estas cifras sitúan al servicio entre los más accesibles del mercado, especialmente para startups y pymes que antes evitaban la IA de voz por su alto coste.
Competencia y contexto global
El anuncio llega en un momento en que los principales actores –Google con Gemini Voice, OpenAI con Whisper + ChatGPT y Microsoft con Azure Speech – están ampliando sus catálogos de IA multimodal. Sin embargo, la propuesta de Alibaba destaca por tres factores:
- Full‑duplex nativo: la mayoría de los servicios comerciales siguen operando en modo half‑duplex, obligando al cliente a gestionar turnos de habla manualmente.
- Descuentos agresivos: mientras los precios de Whisper y Azure Speech rondan los $10‑$15 por millón de tokens de audio, Qwen‑Audio‑3.1 ofrece menos de la mitad.
- Integración de llamadas a herramientas: el modelo incluye un módulo de “function calling” que permite ejecutar acciones externas (consultas a bases de datos, búsquedas web) sin requerir capas intermedias.
En Latinoamérica y España, donde la adopción de asistentes de voz todavía está en fase de prueba, la reducción de costes puede acelerar la integración de IA conversacional en sectores como la banca, la salud y el comercio electrónico. Empresas locales ya están experimentando con APIs de voz para automatizar centros de atención al cliente; una tarifa más baja y una arquitectura full‑duplex podrían traducirse en tiempos de respuesta más rápidos y una experiencia de usuario más natural.
Implicaciones prácticas para desarrolladores y empresas
Desde el punto de vista técnico, la disponibilidad como API gestionada elimina la necesidad de entrenar o alojar pesos propios. No se han publicado los pesos del modelo, lo que implica que los usuarios deben depender de la infraestructura de QwenCloud. Para la mayoría de los casos de uso, esto no representa una limitación, pues la latencia típica reportada está en el rango de 150‑250 ms por turno, comparable con los mejores servicios de la competencia.
Los requisitos de hardware son modestos: cualquier servidor con una GPU de al menos 12 GB de VRAM (por ejemplo, una NVIDIA RTX 3060) puede manejar varias sesiones concurrentes bajo la cuota estándar. Los desarrolladores pueden integrar la API mediante WebSocket, enviando fragmentos de audio en tiempo real y recibiendo respuestas en streaming, lo que simplifica la construcción de bots de voz interactivos.
Un punto a considerar es la política de precios basada en tokens; los equipos de producto deberán estimar el consumo de audio y texto para evitar sorpresas en la facturación. Alibaba ofrece una capa de caché de contexto que reduce la necesidad de volver a enviar el historial completo, lo que también ayuda a controlar costos.
Perspectiva para el ecosistema iberoamericano
El lanzamiento de Qwen‑Audio‑3.1‑Realtime coloca a Alibaba como un competidor serio en el mercado de IA de voz de habla hispana. La empresa ya cuenta con centros de datos en Asia y ha abierto recientemente una zona de disponibilidad en Sudamérica, lo que promete menores latencias para usuarios en Brasil, México y Argentina.
En España, donde la regulación de datos de voz está alineada con el Reglamento General de Protección de Datos (RGPD), la posibilidad de usar un servicio en la nube con cifrado de extremo a extremo y políticas de retención claras será clave para la adopción en sectores regulados como la salud y la banca. Alibaba ha señalado que el modelo cumple con los estándares de privacidad internacionales, aunque los detalles de auditoría aún no se han publicado.
Qwen‑Audio‑3.1‑Realtime ofrece una combinación de arquitectura avanzada, precios competitivos y disponibilidad global que podría redefinir la barrera de entrada para la IA conversacional en el mundo hispanohablante. Los próximos meses verán pruebas piloto en startups fintech de México, plataformas de e‑learning en Colombia y centros de atención al cliente en Madrid, lo que ofrecerá datos reales sobre el impacto de esta tecnología en la productividad y la experiencia del usuario.
