

La paradoja del sonido en la IA: por qué un solo número en la tabla es una trampa
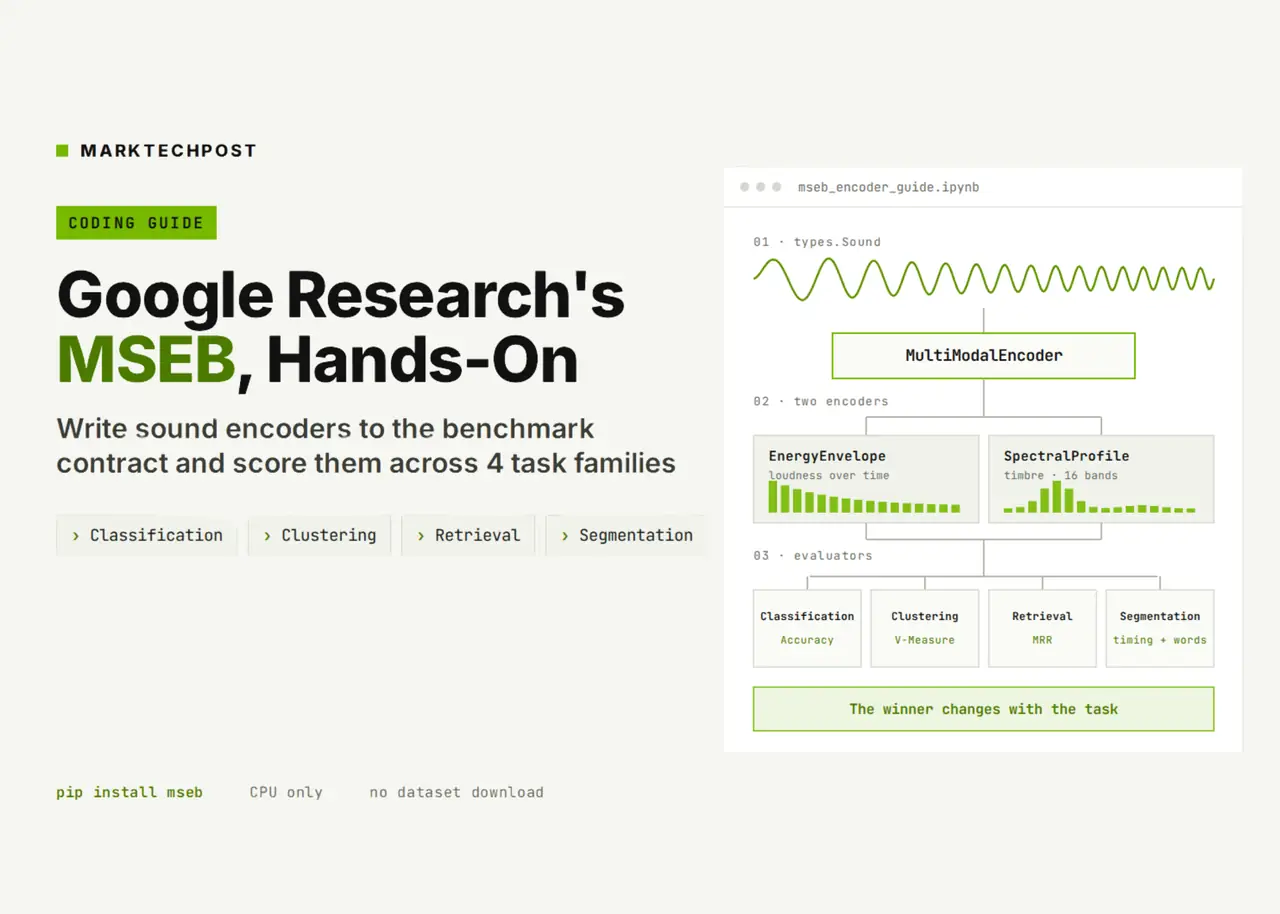
La suite de evaluación MSEB de Google Research expone cómo los modelos de representación de sonido sacrifican timbre por estructura temporal, demostrando la fragilidad de las métricas unificadas en audio.
Evaluar el rendimiento de un modelo de procesamiento de lenguaje natural suele reducirse a métricas estandarizadas en compresión o comprensión semántica. Sin embargo, cuando la inteligencia artificial se enfrenta a la señal acústica, reducir la calidad de un codificador a una única puntuación en una tabla clasificatoria no solo es impreciso: es técnicamente engañoso. La arquitectura del sonido impone que un vector vectorial optimizado para reconocer el timbre de un instrumento sea, por definición matemática, deficiente al delimitar el momento exacto en que un hablante interrumpe a otro.
Para abordar esta distorsión en la investigación de modelos multimodales, los ingenieros de Google Research han estructurado MSEB (Massive Sound Embedding Benchmark). La herramienta descompone las capacidades de los codificadores de audio en contratos de evaluación independientes, demostrando de forma cuantitativa que el liderazgo de un modelo en una tarea específica suele implicar un peaje inasumible en otras.
La arquitectura en tres capas que audita las representaciones vectoriales
El diseño conceptual de MSEB no busca imponer un único modelo victorioso, sino forzar a los desarrolladores a enfrentar la superficie real de evaluación. La infraestructura de la librería se organiza en tres capas estrictamente desacopladas que determinan cómo interactúan los datos y los algoritmos:
- Tipos estandarizados (
types): Define las estructuras universales de datos compartidas por el benchmark, incorporando entidades estrictas comoSound,SoundEmbedding,ScoreyTaskMetadata. Esta capa garantiza que cualquier modelo intercambie tensores sin acoplamiento previo con el entorno de pruebas. - Contrato del codificador (
encoder): Establece la clase base abstractaMultiModalEncoder. Es la interfaz obligatoria que cualquier arquitectura debe implementar para transformar ondas sonoras crudas o espectrogramas en vectores de embedding de dimensión fija. - Batería de evaluadores (
evaluators): Agrupa los módulos especializados que someten los vectores a pruebas aisladas. Incluye ejecutores independientes para clasificación, agrupamiento (clustering), recuperación de información (retrieval) y segmentación temporal.
Esta separación modular expone la realidad técnica subyacente: un codificador diseñado únicamente para capturar la sonoridad acumulada a lo largo del tiempo obtendrá resultados sobresalientes en segmentación de eventos, pero fallará estrepitosamente cuando el evaluador de clustering_evaluator le exija agrupar grabaciones según el matiz tímbrico del emisor.
Evaluadores aislados frente al sesgo de las métricas agregadas
Durante la ejecución de las pruebas, los módulos classification_evaluator, clustering_evaluator, retrieval_evaluator y segmentation_evaluator consumen las representaciones vectoriales generadas por la interfaz del modelo. Dado que estos evaluadores dependen exclusivamente de cálculos algebraicos en NumPy y scikit-learn, prescinden de marcos de ejecución pesados y permiten aislar las matemáticas del rendimiento sin la interferencia de componentes de transcripción o decodificación de voz pesados.
Al enfrentar un codificador centrado en variaciones de energía contra otro enfocado en la distribución espectral del timbre, los evaluadores demuestran mecánicamente que el orden en la tabla de clasificación se invierte según la tarea planteada. En pruebas de segmentación temporal, la precisión de frontera favorece la métrica de sonoridad. Por contra, cuando el módulo retrieval_evaluator mide la distancia del espacio vectorial para recuperar pistas similares, la matriz de espectro tímbrico domina la tabla.
Esta dinámica valida el propósito de asociar cada envío de resultados a una instancia de TaskMetadata. Un modelo de inteligencia artificial de audio no posee un valor absoluto de efectividad; su utilidad está determinada mecánicamente por la métrica concreta que el desarrollador decide primar en el contrato de evaluación.
El dilema de la especialización frente a la versatilidad en audio
La perspectiva técnica que introduce este marco de Google Research pone en evidencia la trampa del optimizador único en el procesamiento de señales. Para las empresas e investigadores que integran modelos de audio en producción, el costo de inferencia y la selección de arquitectura no pueden guiarse por promedios agregados. La compresión de datos acústicos exige elegir qué información se destruye en el proceso de embedding y qué frecuencias se conservan en la matriz vectorial.
La adopción de benchmarks con contratos de evaluación explícitos como MSEB desplazará el interés comercial desde la búsqueda de modelos universales hacia codificadores especializados por tarea. A medida que las aplicaciones de procesamiento de voz y análisis acústico en tiempo real demanden menor latencia y menor huella de memoria, la industria deberá asumir que el modelo perfecto no existe: solo existen vectores de representación ajustados a la física del problema que intentan resolver.
