

RAG privado en local: cómo chatear con tus documentos y PDFs confidenciales sin enviar datos a internet
El auge de la inteligencia artificial ha colocado a empresas y profesionales en una encrucijada crítica: la necesidad de aprovechar el poder de los modelos de lenguaje sin comprometer la confidencialidad de sus datos. Subir balances financieros, historiales médicos o contratos legales a servicios en la nube como ChatGPT o Claude no siempre es una opción viable debido a regulaciones como el RGPD o estrictos acuerdos de no divulgación (NDA).
La solución técnica a este dilema es implementar una arquitectura RAG (Retrieval-Augmented Generation) completamente local. En este tutorial paso a paso, aprenderás a construir un motor de búsqueda semántica y consulta de documentos que corre 100 % en tu propia máquina, sin enviar un solo byte a servidores externos.
Arquitectura básica de un sistema RAG local
Un sistema RAG no reentrena el modelo de IA; en su lugar, actúa como un bibliotecario de alta velocidad. Cuando haces una pregunta, el sistema busca en tu propia base de datos vectorial los fragmentos exactos que contienen la respuesta, y luego se los entrega al modelo para que redacte una síntesis precisa basada exclusivamente en tus hechos.
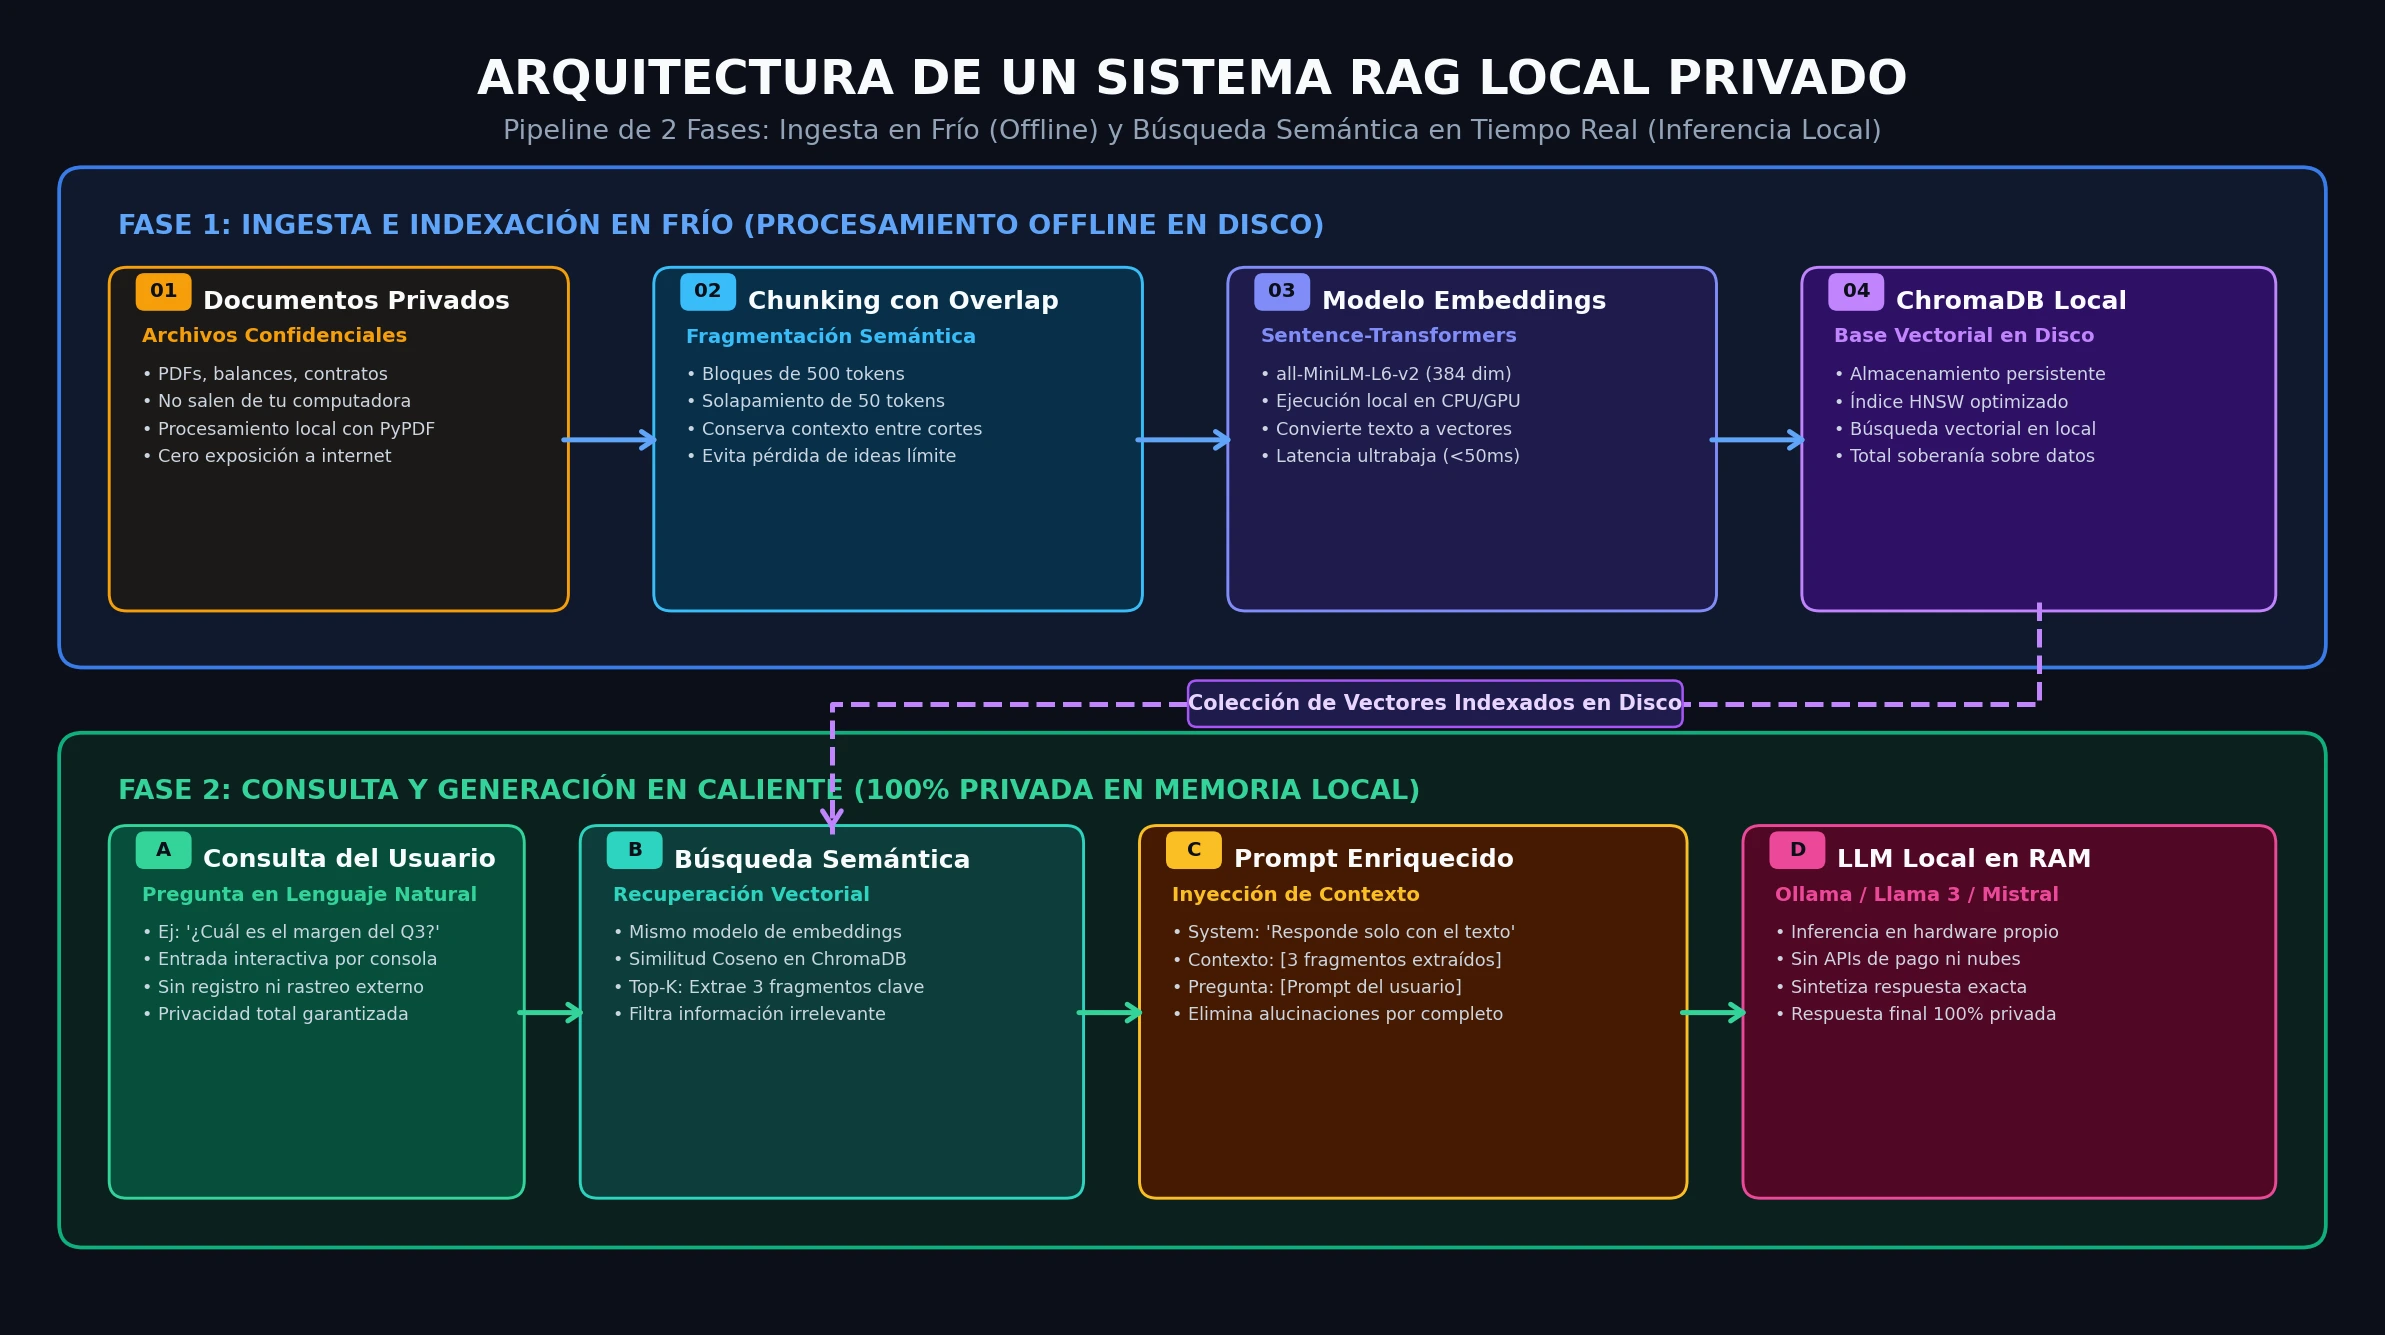
El flujo se compone de cuatro etapas esenciales:
- Extracción e Ingesta: Lectura del documento original (PDF, Markdown o texto plano).
- Fragmentación (Chunking): División del texto en bloques pequeños y coherentes para no saturar la memoria.
- Vectorización (Embeddings): Transformación de cada fragmento de texto en un vector numérico que captura su significado semántico.
- Almacenamiento y Recuperación: Guardado de vectores en disco local mediante ChromaDB y búsqueda de coincidencias mediante similitud de coseno.
Paso 1: Preparación del entorno de desarrollo
Para garantizar que todo funcione de manera aislada y limpia, comenzaremos creando un entorno virtual en Python 3.10 o superior e instalando las cuatro dependencias clave: chromadb para la base vectorial, sentence-transformers para los embeddings locales, pypdf para la lectura de documentos y langchain-text-splitters para la fragmentación inteligente.
La primera vez que ejecutes el script, la librería descargará automáticamente el modelo de embeddings all-MiniLM-L6-v2 (~80 MB). Este modelo corre con una velocidad asombrosa en cualquier CPU moderna sin requerir tarjetas gráficas dedicadas.
Paso 2: Código completo de implementación en Python
Crea un archivo llamado rag_privado.py y copia la siguiente implementación estructurada. Cada bloque cuenta con control de flujo para procesar cualquier documento PDF que coloques en la misma carpeta:
Paso 3: Cómo funciona la fragmentación con solapamiento (Overlap)
Uno de los errores más comunes en arquitecturas RAG novatas es cortar el texto de forma arbitraria por número de caracteres. Si un párrafo dice: «El plazo de garantía no cubre daños por agua…» y el corte ocurre justo en la palabra «no», el modelo puede entender lo opuesto.
Por esta razón, utilizamos RecursiveCharacterTextSplitter con un chunk_size de 600 caracteres y un overlap de 100 caracteres. El solapamiento asegura que el final de un bloque se repita al inicio del siguiente, preservando el contexto semántico y evitando que las oraciones clave queden mutiladas.
Comparativa técnica: Bases de datos vectoriales para entornos locales
Aunque en esta guía utilizamos ChromaDB por su facilidad de integración en Python, existen varias alternativas sólidas según la escala de tus documentos:
Paso 4: Conectar los fragmentos con un modelo de lenguaje local
Una vez que la función consultar_documentos() te devuelve los 3 fragmentos más relevantes de tu PDF, el paso final consiste en pasárselos a un modelo que redacte la respuesta en lenguaje natural. Puedes conectar este script directamente con herramientas locales como Ollama o llama.cpp utilizando el siguiente formato de prompt:
Buenas prácticas de seguridad y producción
- Persistencia local garantizada: Al inicializar ChromaDB con
PersistentClient(path="./mi_base_vectorial"), los vectores se guardan en una base de datos SQLite embebida en tu disco duro. Puedes apagar tu ordenador y tus datos seguirán ahí sin tener que volver a procesar el PDF. - Cero fugas de red: Para auditar que ningún paquete salga a internet, puedes desconectar el Wi-Fi o ejecutar el script con un cortafuegos local; comprobarás que la indexación y la búsqueda vectorial operan al 100 % offline.
- Documentos multilingües: Si tus PDFs están en español y contienen vocabulario técnico complejo, puedes sustituir el modelo de embeddings por
paraphrase-multilingual-MiniLM-L12-v2cambiando únicamente una línea de código.
