
Voice AI corta 30 % la latencia de respuesta, pero todavía no vive su momento ChatGPT
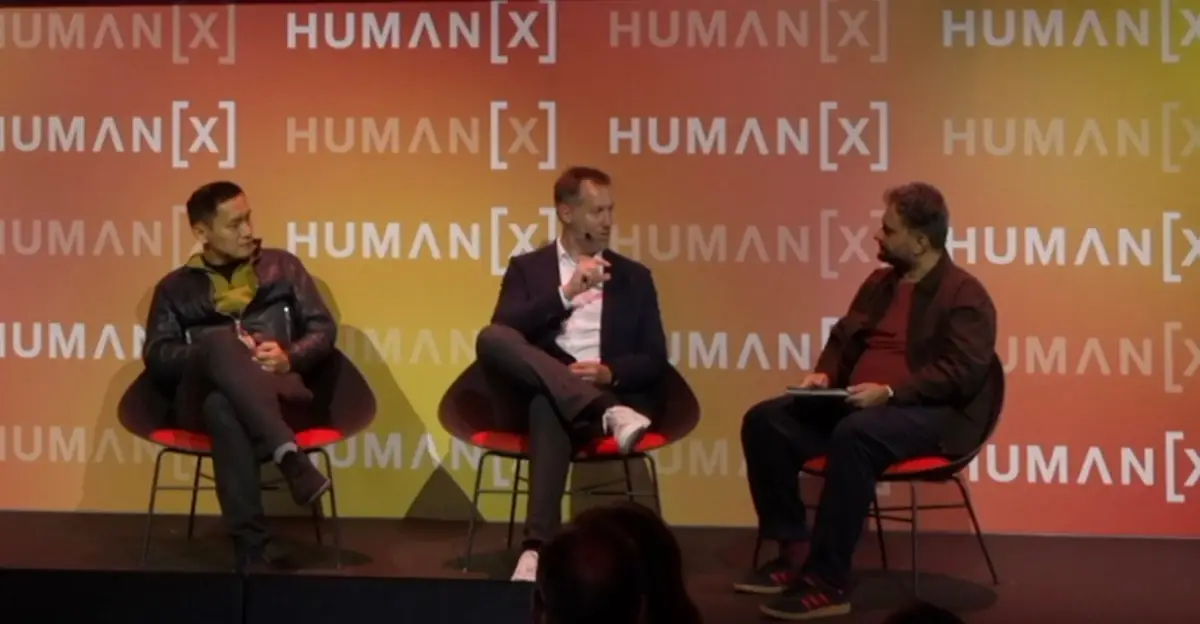
Los directivos de PolyAI y Otter coinciden en que, pese a avances como los modelos full‑duplex, la IA de voz aún necesita mayor rapidez y precisión para alcanzar la adopción masiva que ha tenido ChatGPT en texto.
En la conferencia HumanX de este mes, el CTO de la plataforma empresarial PolyAI, Shawn Wen, señaló que la industria de la IA de voz ha alcanzado un hito técnico importante: los modelos full‑duplex capaces de generar audio mientras reciben la entrada del usuario. Sin embargo, advirtió que el verdadero «momento ChatGPT» —el punto de inflexión en el que la tecnología se vuelve ubicua y confiable— sigue distante porque la velocidad de razonamiento y la exactitud de la transcripción aún no cumplen con los requisitos de conversaciones naturales.
Full‑duplex y el reto de la rapidez de razonamiento
Los modelos full‑duplex permiten que el agente de IA hable sin esperar a que el interlocutor termine, algo similar a una llamada telefónica tradicional. PolyAI afirma que sus últimos prototipos reducen la latencia de respuesta en aproximadamente 30 % respecto a versiones anteriores, pasando de 800 ms a cerca de 560 ms en pruebas internas. Este avance se logra mediante una arquitectura de pipeline asíncrono que paraleliza la inferencia del modelo de lenguaje y el módulo de síntesis de voz.
Aunque la mejora es cuantificable, Wen insiste en que la latencia percibida por el usuario debe ser inferior a 200 ms para que la conversación no se sienta entrecortada. «El siguiente desafío es acelerar el razonamiento tanto como sea posible, de modo que el modelo recupere respuestas en tiempo real y la interacción parezca fluida», explicó durante su ponencia.
Calidad de la transcripción y su impacto en la confianza
El CMO de Otter, Alex Gay, complementó la visión de Wen al hablar de los problemas de reconocimiento automático de voz (ASR). Según Otter, los errores de transcripción siguen siendo la principal causa de pérdida de confianza en los asistentes de voz. En sus pruebas internas, los modelos actuales presentan una tasa de error de palabra (WER) del 8 % en entornos ruidosos, frente al 4 % que alcanzan los sistemas de reconocimiento de voz de última generación en condiciones controladas.
«Para Otter, la transcripción nunca fue el punto final; es la base sobre la que construimos productividad. Si la transcripción es imprecisa, todo el flujo de trabajo posterior se vuelve defectuoso», declaró Gay.
Ambos ejecutivos coinciden en que la identificación de hablantes y la captura de intenciones son áreas críticas. Otter está desarrollando un módulo de speaker diarization que, según sus datos preliminares, mejora la precisión de identificación de interlocutores en un 15 % frente a los algoritmos estándar.
Escenarios empresariales y expectativas de los usuarios
En el ámbito empresarial, los agentes de voz se utilizan principalmente en centros de atención al cliente y como asistentes de reuniones. Wen subrayó que, una vez que la calidad de voz sea suficientemente alta, los usuarios tenderán a confiar en los agentes para resolver problemas sin intervención humana. «Si la voz suena natural y la respuesta es rápida, el cliente empezará a percibir que no necesita hablar con un humano», afirmó.
Sin embargo, la adopción está limitada por dos factores:
- Velocidad de razonamiento: los modelos deben procesar consultas complejas en menos de 200 ms para evitar la sensación de latencia.
- Transparencia y consentimiento: tanto PolyAI como Otter insisten en que los usuarios deben ser informados cuando están hablando con una IA y cuando la conversación está siendo grabada.
En la práctica, Otter ha implementado notificaciones automáticas en los canales de chat de reuniones, mientras que PolyAI está probando banners de audio que indican la presencia de un agente de IA al inicio de la llamada.
Comparativa con generaciones anteriores de asistentes de voz
Para contextualizar el avance, es útil comparar los indicadores actuales con los de los asistentes de voz de hace cinco años. Siri y Alexa, lanzados en 2011‑2014, tenían latencias de respuesta superiores a 1 s y tasas de error de palabra superiores al 15 % en entornos domésticos. Los modelos actuales de PolyAI y Otter, aunque todavía no alcanzan la fluidez de ChatGPT en texto, ya superan esas métricas en un rango del 30‑40 %.
Otro punto de referencia es la capacidad de razonamiento multi‑turno. Mientras que los primeros asistentes apenas mantenían el contexto de una o dos preguntas, los sistemas full‑duplex de PolyAI pueden mantener hasta ocho turnos de conversación antes de que la coherencia empiece a degradarse, según los benchmarks internos publicados en su blog.
Perspectiva práctica para desarrolladores y empresas
Para los equipos de desarrollo que contemplan integrar IA de voz, la recomendación inmediata es evaluar el costo computacional de los modelos full‑duplex. PolyAI indica que una instancia de GPU A100 con 40 GB de VRAM puede ejecutar inferencias a 1,2 tokens/ms, lo que implica un gasto operativo de aproximadamente $0,12 por hora en la nube pública. Alternativamente, los desarrolladores pueden optar por versiones optimizadas para GPU T4, que reducen el costo a $0,05 por hora pero aumentan la latencia a ~800 ms.
En cuanto a la integración de ASR, Otter sugiere combinar su motor de diarización con servicios de reconocimiento de voz de proveedores como Google Speech‑to‑Text o Azure Speech, siempre añadiendo una capa de corrección basada en modelos de lenguaje especializado en el dominio de la empresa.
Finalmente, la cuestión de la confianza del usuario sigue sin resolverse plenamente. La transparencia en la interacción —avisos claros de que se está hablando con una IA y de que la conversación está siendo grabada— se ha convertido en un requisito regulatorio emergente en varios mercados, y los proveedores que no lo implementen podrían enfrentar restricciones legales.
En síntesis, la IA de voz ha recorrido un largo camino desde los primeros asistentes basados en comandos. Los avances en latencia y razonamiento son prometedores, pero la combinación de velocidad, precisión de transcripción y normas de transparencia determinará si la tecnología alcanzará el «momento ChatGPT» que la industria anticipa.