
Por qué MASS busca que la IA se convierta en su propio optimizador y evaluador
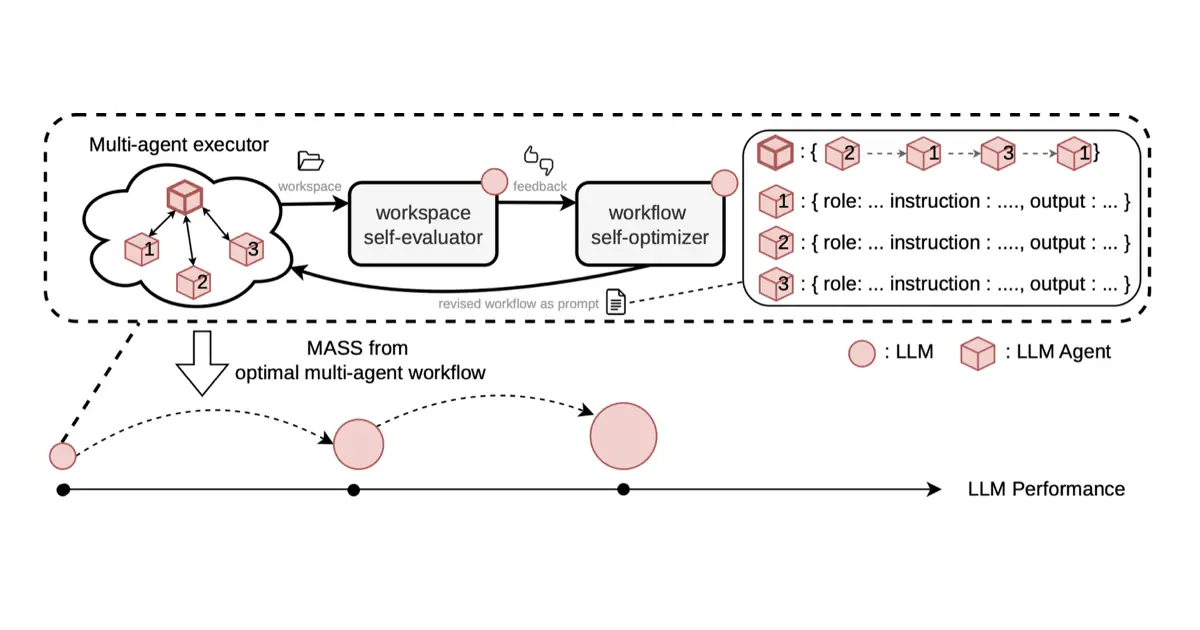
Sakana AI presenta MASS, un marco de auto‑supervisión multi‑agente que permite a un único modelo de lenguaje actuar como ejecutor, optimizador y evaluador en un bucle de mejora recursiva.
En un comunicado publicado el 11 de octubre de 2026, el equipo de investigación de Sakana AI reveló MASS (Multi‑Agent Self‑Supervision), un enfoque que pretende que la propia IA sea su mejor optimizador y evaluador. El proyecto, desarrollado durante una pasantía en la compañía, muestra mejoras medibles en la puntuación por token en varios benchmarks de investigación, lo que sugiere que la IA puede aprender de la inteligencia colectiva que genera sin depender de supervisión externa tradicional.
El bucle de auto‑supervisión que propone MASS
El concepto central de MASS es la mejora recursiva homogénea (RSI, por sus siglas en inglés). En este esquema, el optimizee –el modelo que resuelve la tarea– también cumple el papel de optimizador y evaluador. El proceso se divide en dos bucles:
- Bucle interno: el modelo, con pesos fijos, explora diferentes flujos de trabajo de un equipo multi‑agente y elige, mediante una auto‑evaluación, la configuración que produce mejores resultados.
- Bucle externo: una vez identificado el flujo óptimo, el modelo actualiza sus pesos aprendiendo de las ejecuciones del equipo bajo ese flujo.
De esta forma, el modelo destila la «inteligencia colectiva» del equipo en una señal de auto‑supervisión que alimenta la siguiente iteración. El artículo subraya que el flujo de trabajo está codificado como un plan escrito que el orquestador asigna a sub‑agentes y cuya estructura se vuelve visible para el modelo en cada paso.
Cómo funciona la optimización de flujos multi‑agente
Un flujo de trabajo en MASS incluye cuatro componentes básicos: la generación de resultados, la inspección de esos resultados, la comparación entre distintas ejecuciones y la justificación de la elección final. Por ejemplo, en una tarea financiera, el modelo crea datos sintéticos, construye características, entrena un modelo predictivo y realiza una auditoría que verifica la ausencia de «leakage» temporal. Cada sub‑agente produce un artefacto (gráfica, tabla, informe) que pasa al siguiente agente, y el evaluador final decide cuál de los dos flujos de trabajo (por ejemplo, con o sin auditoría) cumple mejor con los criterios definidos.
El proceso se alimenta de tareas «no verificables»: problemas de investigación donde no existe una señal de recompensa automática y la validación depende de juicio humano o de pruebas costosas. Para medir el progreso, los autores solicitaron a modelos externos (GPT‑5.5 y Claude Opus 4.8) que evaluaran los resultados generados por MASS, manteniendo esas evaluaciones fuera del bucle interno para evitar sesgos.
«Esperamos que MASS contribuya al momento odiseico de la IA», declaró el equipo de Sakana AI.
Evaluación externa y límites de la autorreflexión
El uso de evaluadores externos sirve como control de calidad independiente. Sin embargo, la propia arquitectura de MASS plantea preguntas críticas. ¿Puede un modelo que se evalúa a sí mismo evitar la deriva de métricas cuando la señal de retroalimentación es generada internamente? Los autores admiten que la precisión de la auto‑evaluación es desconocida y que, en ausencia de supervisión externa, el modelo podría reforzar patrones subóptimos.
Otro punto de tensión es la escalabilidad. La experimentación se realizó con modelos de tamaño intermedio, y los autores no han divulgado los requerimientos exactos de cómputo ni los costes energéticos de los bucles internos. Sin datos concretos, la comunidad todavía no puede estimar si MASS será viable en entornos de producción o si seguirá limitado a laboratorios de investigación.
Implicaciones para la carrera de IA y los riesgos asociados
Si MASS logra que los sistemas de IA se supervisen y optimicen sin intervención humana, el ritmo de progreso podría acelerar significativamente, especialmente en dominios donde la experticia humana es escasa o los experimentos son prohibitivamente costosos. Esto coincide con la visión de los autores de superar «el cuerpo de conocimiento acumulado por la humanidad» y llegar a un punto en que incluso los expertos humanos no puedan evaluar los resultados de manera fiable.
No obstante, la misma autonomía plantea riesgos. Un modelo que decide por sí mismo qué flujo de trabajo es «óptimo» podría converger hacia soluciones que maximizan métricas internas sin alinearse con valores humanos o consideraciones de seguridad. La falta de supervisión externa directa también complica la detección de sesgos emergentes o de comportamientos indeseados.
MASS representa una apuesta audaz por la auto‑mejora recursiva basada en la inteligencia colectiva generada por el propio modelo. Su éxito dependerá de la capacidad de la comunidad para validar de forma independiente las mejoras y para diseñar mecanismos de control que limiten la deriva de la auto‑supervisión.