

Verificación de fuentes en agentes LLM: precisión vs atribución errónea
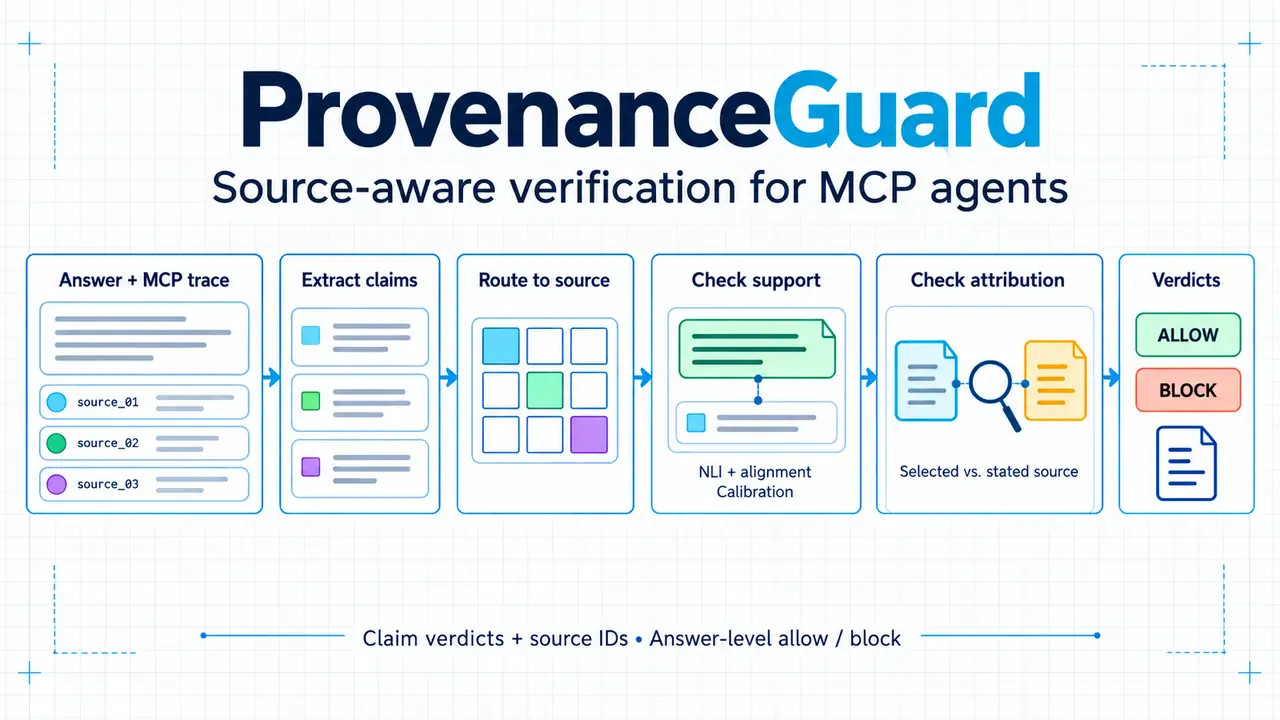
Hugging Face presenta ProvenanceGuard, una capa de verificación post‑generación que detecta cuando los agentes LLM basados en el Model Context Protocol atribuyen una afirmación al origen equivocado, evitando la confusión de fuentes cruzadas.
Los agentes LLM que utilizan el Model Context Protocol (MCP) ya no se limitan a extraer información de un único pasaje recuperado; pueden consultar bases de datos, registros estructurados y herramientas de búsqueda antes de generar una respuesta. Este nuevo nivel de interacción introduce un problema de factualidad que los verificadores tradicionales no capturan: la conflación de fuentes, es decir, afirmar que un dato proviene de un origen cuando en realidad se extrajo de otro.
El desafío de la atribución en agentes MCP
Los métodos de evaluación de factualidad como RAGAS, MiniCheck, AlignScore o SummaC operan bajo la premisa de que toda la evidencia está ya consolidada en un único contexto. Cuando la evidencia proviene de múltiples herramientas, el verificador “ciego a la fuente” verifica que la afirmación exista en el conjunto, pero no comprueba que la fuente citada por el agente coincida con la que realmente la sustentó. En dominios sensibles, como atención médica o soporte financiero, una atribución incorrecta puede ser tan dañina como una información errónea.
Cómo funciona ProvenanceGuard paso a paso
ProvenanceGuard se coloca como una capa post‑generación sobre cualquier agente MCP, sin necesidad de volver a entrenar el modelo subyacente. El proceso se desglosa en cinco fases:
- Descomposición de la respuesta: el texto generado se segmenta en afirmaciones individuales mediante un modelo de lenguaje local.
- Identificación de la fuente relevante:
MiniLMbusca entre los outputs de las herramientas MCP el registro que mejor corresponde a cada afirmación. - Validación de soporte: un modelo
DeBERTaentrenado para inferencia natural del lenguaje (NLI) verifica si la fuente encontrada realmente respalda la afirmación. - Comparación de atribución: se confronta la fuente detectada con la que el agente menciona explícita o implícitamente (por ejemplo, “según el registro de cuenta”).
- Decisión final: se emite un veredicto por afirmación y una decisión global de allow o block. En caso de bloqueo, se activa un módulo de reparación estilo RARR que genera una respuesta corregida y vuelve a pasarla por el verificador.
Todo el flujo mantiene la identidad de la fuente a lo largo del pipeline, evitando que la evidencia se anonimice en un único bloque de texto.
Resultados experimentales y limitaciones
Los autores evaluaron ProvenanceGuard con un agente médico que consultaba tres tipos de fuentes: historial del paciente, artículos de investigación y documentos de política interna. De los 281 rastros reales analizados, los verificadores tradicionales aprobaban el 68 % de las respuestas, aunque el 22 % de esas aprobaciones correspondían a conflación de fuentes. ProvenanceGuard redujo la tasa de aprobaciones falsas al 5 %, manteniendo una precisión de detección de errores del 92 %.
Es importante señalar que los experimentos se realizaron con modelos locales para garantizar un entorno controlado. La arquitectura no depende de MiniLM o DeBERTa; cualquier modelo que pueda realizar búsqueda de similitud y razonamiento NLI podría integrarse, siempre que se ajuste y calibre adecuadamente.
Implicaciones prácticas para desarrolladores y reguladores
Para los equipos que despliegan agentes MCP, ProvenanceGuard ofrece una solución que no implica cambios en la arquitectura del modelo generador, sino una capa adicional que puede activarse o desactivarse según la sensibilidad del dominio. En entornos regulados, como la atención sanitaria, la capacidad de demostrar que cada afirmación está vinculada a la fuente correcta facilita el cumplimiento de normativas de trazabilidad de datos.
Sin embargo, la herramienta añade latencia: el proceso de descomposición, búsqueda y verificación añade entre 150 ms y 400 ms por respuesta, según la complejidad del trace. Los operadores deben balancear la necesidad de rapidez contra el riesgo de atribuciones erróneas.
ProvenanceGuard amplía la noción de factualidad al incluir la proveniencia de la información, un paso necesario para que los agentes LLM basados en MCP sean confiables en escenarios críticos.
