

El nuevo motor de búsqueda que entiende el significado de la ciencia
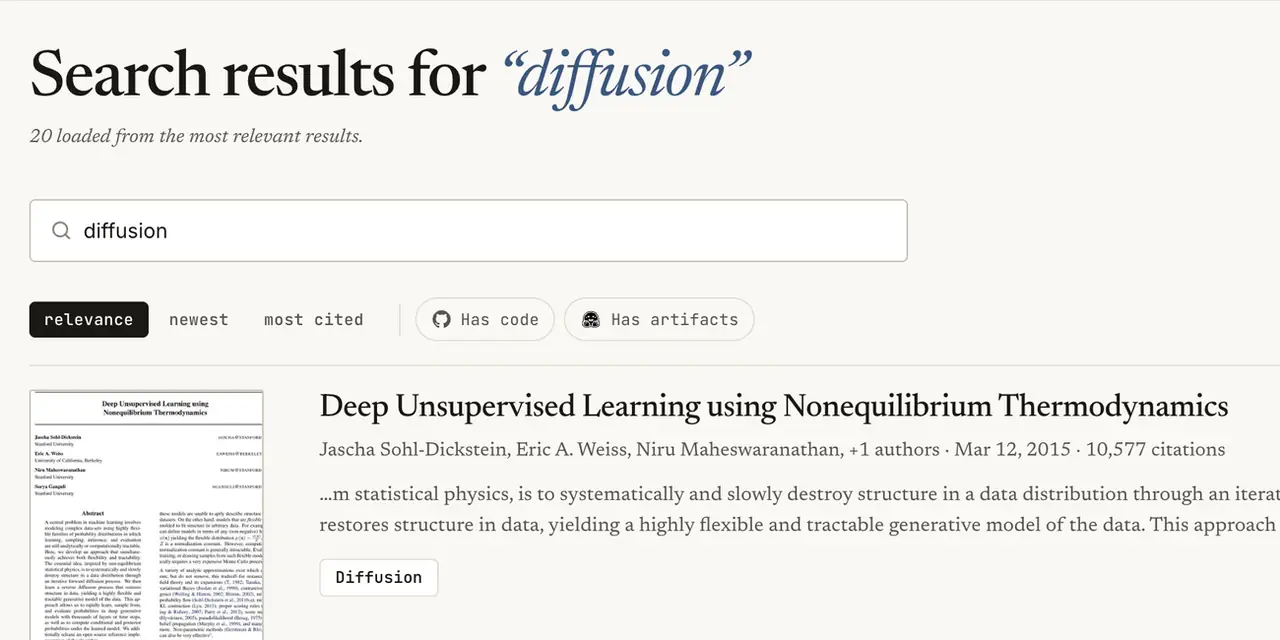
La plataforma Papers with Code renueva por completo su sistema de búsqueda gracias a la infraestructura de Hugging Face, permitiendo a investigadores de todo el mundo encontrar avances científicos por su significado y no solo por palabras exactas.
¿Alguna vez has intentado buscar un libro en una biblioteca inmensa sin recordar el título exacto ni el nombre del autor? Tradicionalmente, la búsqueda de documentos científicos en internet se ha parecido mucho a esa frustrante experiencia. Si no escribías la palabra clave exacta que el investigador usó en su estudio, el documento simplemente permanecía invisible, enterrado bajo toneladas de información digital. Sin embargo, esto acaba de cambiar de forma radical para una de las mayores fuentes de conocimiento en inteligencia artificial del planeta.
La popular plataforma Papers with Code, el repositorio donde la comunidad científica global comparte sus investigaciones junto con el código fuente para replicarlas, ha transformado por completo su arquitectura interna. A través de una publicación oficial en el blog de Hugging Face, los ingenieros responsables de este proyecto revelaron cómo han logrado que encontrar un estudio técnico sea tan intuitivo como mantener una conversación con un experto.
Más allá de las palabras clave: cuando las máquinas leen la ciencia
Imagina que tienes un asistente personal que no solo memoriza las palabras de un texto, sino que entiende el concepto profundo que hay detrás de ellas. Si le pides «algo sobre vehículos que se manejan solos», no buscará únicamente la frase literal «vehículos que se manejan solos»; entenderá inmediatamente que también debe mostrarte documentos sobre automóviles autónomos, sensores LiDAR o visión computacional aplicada al transporte. Eso es exactamente lo que se conoce como búsqueda semántica.
Para lograr este salto cualitativo, el equipo de desarrollo tuvo que migrar un catálogo masivo que abarca cientos de miles de artículos científicos y repositorios de código. El reto no era pequeño: cómo procesar de manera continua y eficiente gigabytes de datos técnicos sin que el motor de búsqueda se vuelva lento o prohibitivamente costoso de mantener.
La respuesta estuvo en una combinación de modelos de procesamiento de lenguaje natural y vectores matemáticos. Al convertir cada título, resumen y fragmento de código en un vector (una especie de mapa numérico que representa el significado de las palabras), la máquina puede comparar distancias conceptuales. Si dos conceptos están cerca en ese mapa tridimensional, la plataforma sabe que están relacionados, independientemente del idioma o del vocabulario específico que hayan utilizado los científicos.
El engranaje invisible tras millones de documentos científicos
¿Cómo se traduce esta teoría a la práctica técnica diaria? Para mover semejante montaña de información, el equipo recurrió a tres piezas fundamentales de infraestructura digital que funcionan de forma coordinada, como una cadena de montaje altamente automatizada:
- Puntos de inferencia dedicados (Inference Endpoints): Son servidores optimizados que ejecutan modelos de IA bajo demanda. Cada vez que se añade un nuevo artículo científico, este sistema genera su representación matemática en cuestión de milisegundos.
- Trabajos automatizados en segundo plano (Jobs): Imagina un escuadrón de noctámbulos que revisa todo el catálogo cada noche. Estos procesos automatizados analizan miles de archivos pesados de forma masiva para actualizar el índice global sin interrumpir las búsquedas de los usuarios.
- Depósitos de datos en la nube (Buckets): Almacenes digitales seguros de gran capacidad donde se guardan las bases de datos vectoriales y las copias de respaldo, permitiendo que la información esté disponible al instante desde cualquier parte del mundo.
Gracias a esta arquitectura modular, las consultas que antes tardaban segundos en devolver resultados rígidos ahora se resuelven en una fracción de segundo, ofreciendo respuestas contextuales mucho más precisas e intuitivas.
¿Por qué organizar el conocimiento humano es el mayor reto de la IA?
A primera vista, mejorar un buscador puede parecer un avance meramente técnico o incremental. Sin embargo, en el acelerado universo de la inteligencia artificial, la velocidad a la que se publica nuevo conocimiento supera con creces la capacidad humana de absorción. Cada semana se dan a conocer miles de descubrimientos, lo que crea un fenómeno que los expertos denominan «sobrecarga de información».
Cuando los investigadores no pueden encontrar eficientemente lo que otros ya han descubierto, se produce una duplicación de esfuerzos: científicos en distintos rincones del mundo terminan invirtiendo meses en resolver un problema que alguien ya solucionó la semana anterior. Al perfeccionar los motores de búsqueda mediante inteligencia artificial, se facilita una especie de «polinización cruzada» entre distintas disciplinas científicas, acelerando el ritmo de la innovación global.
💡 El panorama general: ¿Cómo nos afecta esto?
Aunque este avance beneficia directamente a la comunidad de investigadores, desarrolladores e ingenieros de software, su impacto indirecto alcanza a toda la sociedad. Cuando democratizamos y agilizamos el acceso al conocimiento científico, los ciclos de desarrollo de nuevas tecnologías —desde herramientas médicas basadas en IA hasta algoritmos de optimización energética— se reducen drásticamente. Lo que antes tardaba años en trasladarse del laboratorio al mercado ahora puede ocurrir en cuestión de meses.
Además, este movimiento refleja una tendencia inevitable en la industria tecnológica: los sistemas de información ya no se limitan a catalogar datos, sino que buscan comprenderlos. Muy pronto, la forma en que interactuamos con nuestros correos electrónicos, archivos personales o buscadores web cotidianos imitará esta misma estructura semántica. Las búsquedas por palabras clave pronto serán vistas como una reliquia del pasado digital.
En última instancia, iniciativas como esta demuestran que el verdadero poder de la inteligencia artificial no solo reside en generar imágenes o redactar textos, sino en su capacidad silenciosa para organizar la inmensa montaña del conocimiento humano y hacerla accesible para todos.
