

El truco de compresión que hace a la IA más pequeña y más lista
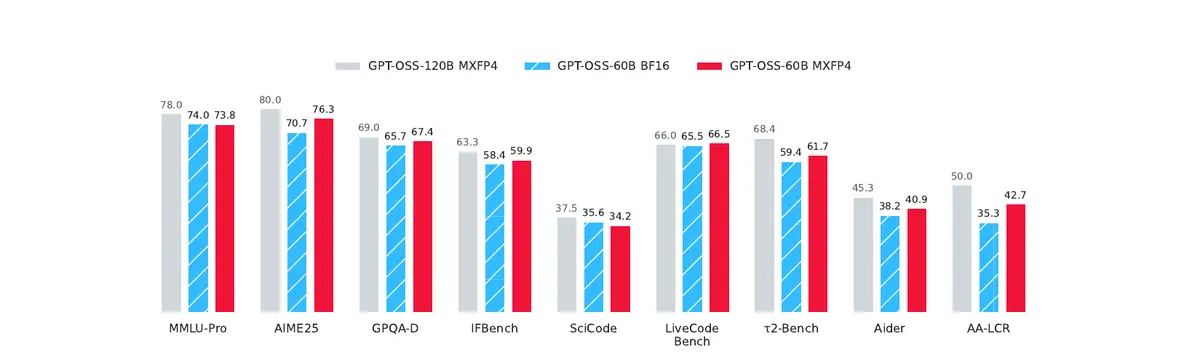
Durante años dimos por sentado que reducir el tamaño de un modelo de inteligencia artificial mermaba sus capacidades. Una nueva técnica demuestra que comprimir una red neuronal puede, paradójicamente, hacerla mejor que la versión original.
Nos han vendido una mentira muy conveniente durante los últimos tres años: para que una inteligencia artificial sea más hábil, inteligente y precisa, necesita ser colosal. Hemos aceptado sin rechistar que la escala bruta es el único camino y que reducir el tamaño de estos modelos para ejecutarlos en dispositivos modestos exigía una tasa de peaje dolorosa en forma de pérdida de rendimiento.
Sin embargo, la narrativa oficial de la industria acaba de recibir un golpe demoledor. Una metodología técnica denominada Quantization-Aware Healing (o ‘curación consciente de la cuantización’) está demostrando algo que muchos sospechábamos pero pocos podían probar: los modelos gigantescos actuales están tan desbordados de redundancia y ruido que, si se comprimen de la manera adecuada, no solo no se vuelven más tontos, sino que terminan superando a su versión original sin comprimir.
El mito del peaje inevitable en la compresión de datos
Para entender la magnitud de este hallazgo, conviene recordar cómo funciona la optimización en el terreno de la inteligencia artificial. Cuando los grandes laboratorios entrenan un modelo, este suele almacenarse en un formato de alta precisión (habitualmente 16 bits o FP16). Para poder ejecutar esos modelos en tarjetas gráficas de consumo, portátiles o teléfonos móviles, los ingenieros recurren a la cuantización: un proceso que ‘recorta’ la precisión matemática de los números a 4 bits para que el archivo ocupe una cuarta parte de su espacio en memoria.
Hasta ahora, frameworks populares como GPTQ, AWQ o BitsAndBytes se consideraban el estándar de oro. El trato era simple: ahorrabas un 75% de memoria VRAM a cambio de perder entre un 2% y un 8% de precisión en benchmarks de razonamiento. Era una degradación asumida en favor de la eficiencia energética y operativa.
Pero el equipo de desarrolladores tras este nuevo avance, según se detalla en el anuncio oficial en la plataforma Hugging Face, ha roto esa regla no escrita. Al aplicar una fase de ‘restauración’ adaptativa durante el propio proceso de compresión a 4 bits, el modelo resultante no solo no pierde facultades, sino que obtiene puntuaciones superiores a las de la versión de 16 bits en pruebas estandarizadas de lenguaje y lógica.
¿Magia negra o pura limpieza de grasa digital?
¿Cómo es posible que una versión comprimida funcione mejor que el original de máxima precisión? La respuesta no es mágica, sino crítica con el estado actual del sector. Los grandes modelos de lenguaje actuales están entrenados mediante fuerza bruta, engullendo petabytes de datos de internet sin un filtrado óptimo. Esto genera redes profundas plagadas de parámetros que almacenan información redundante, sesgos estáticos y ‘ruido’ matemático.
Al forzar al modelo a reducir sus pesos a tan solo 4 bits mientras se aplica un proceso de ajuste fino ‘curativo’, la red se ve obligada a desprenderse de toda esa grasa digital. Es el equivalente técnico a editar un manuscrito de mil páginas escrito con prisas: al eliminar la paja y reorganizar las frases clave, el texto final resulta más claro, directo y coherente que el borrador infinito original.
Esta aproximación pone en evidencia una realidad incómoda para las grandes tecnológicas: nos han estado vendiendo modelos inflados cuyas eficiencias de cómputo dejan muchísimo que desear.
El cambio de fuerzas: quién gana y quién pierde con esta técnica
Este tipo de avances no son simples curiosidades académicas; alteran drásticamente el equilibrio económico de la industria tecnológica actual:
- Los grandes beneficiados: Desarrolladores independientes, la comunidad open source y las pequeñas empresas. Poder ejecutar modelos que rinden como gigantes de centro de datos dentro de hardware modesto elimina la barrera de entrada económica.
- Los grandes perjudicados: Los proveedores de infraestructura en la nube que facturan por horas de uso de complejas granjas de GPUs. Si las empresas pueden ejecutar modelos superiores en sus propios servidores locales usando una fracción de la memoria, el negocio de alquilar potencia bruta desmedida empieza a tambalearse.
- El medio ambiente: Reducir en un 75% el consumo de memoria implica un impacto directo en la huella de carbono y el consumo de energía necesario para inferir respuestas en IA.
💡 El panorama general: ¿Cómo nos afecta esto?
Estamos presenciando una transición crucial en la era de la inteligencia artificial: el paso de la fuerza bruta a la elegancia algorítmica. Durante los últimos tres años, la carrera se basó en ver quién construía el centro de datos más gigantesco y consumía más megavatios. Estrategias de compresión inteligente como esta demuestran que el verdadero rendimiento del futuro no vendrá de gastar más recursos, sino de optimizar radicalmente los que ya tenemos.
Para el usuario común y el profesional no técnico, el impacto será directo en la privacidad y la inmediatez. Que un modelo de 4 bits pueda superar a uno de 16 bits significa que muy pronto tendremos asistentes de IA hipercapaces funcionando 100% de manera local en nuestros teléfonos inteligentes, ordenadores de trabajo o vehículos, sin necesidad de enviar un solo dato a servidores de terceros en Estados Unidos o China y sin depender de una conexión a internet estable.
En definitiva, el futuro de la inteligencia artificial no pertenece necesariamente a los modelos más grandes, sino a los más eficientes. La verdadera innovación de esta década no consistirá en crear cerebros digitales más masivos, sino en aprender a limpiar la paja de los que ya hemos construido.
