
[ÚLTIMA HORA] Meta presenta Muse Wonder, frontera que supera a GPT‑6 y Fable 5.1 en memoria y código
Meta lanzó este lunes Muse Wonder y su versión completa, dos modelos de gran escala que igualan a GPT‑6 Astra y Fable 5.1 en pruebas de razonamiento y, sobre todo, en la capacidad de retener información a largo plazo.
Meta anunció la llegada de Muse Wonder y Muse Wonder Full, sus primeros modelos catalogados como «frontera». Ambos superan a los últimos lanzamientos de OpenAI y Anthropic en los benchmarks de código y de memoria continua, y se ofrecen a través de la Meta Model API con una tarificación que sitúa su coste en la misma franja que los modelos de gama alta de la competencia.
Detalles técnicos de Muse Wonder
Mientras que el modelo ligero Muse Spark fue diseñado para responder en milisegundos con un consumo mínimo de recursos, Muse Wonder se posiciona como una arquitectura de mayor capacidad. Según la hoja de modelo publicada por Meta, Wonder cuenta con varios cientos de miles de millones de parámetros, lo que le permite procesar contextos extensos sin perder precisión.
En pruebas de referencia, Muse Wonder y su versión completa alcanzaron puntuaciones comparables a Fable 5.1 y GPT‑6 Astra en tareas de razonamiento lógico y generación de código. En el benchmark MemoryBench, que evalúa la habilidad del modelo para aprender y recordar información a lo largo de interacciones continuas, Muse Wonder obtuvo los mejores resultados frente a sus rivales.
Memoria activa — el nuevo enfoque de Meta
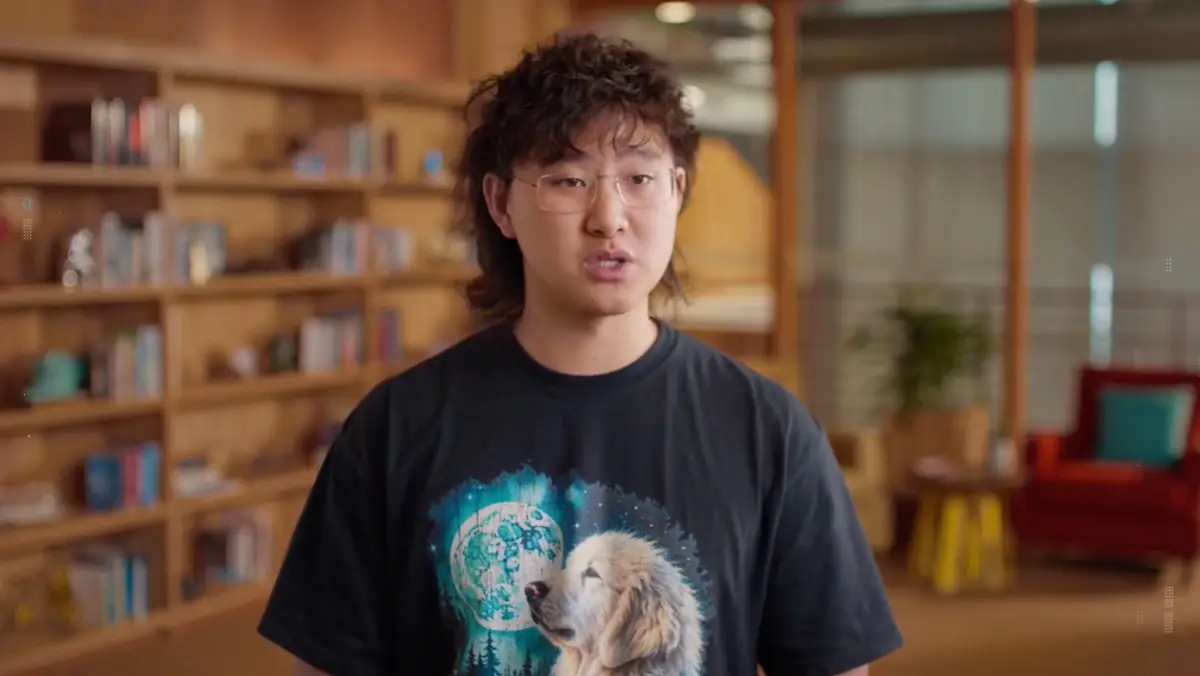
Meta ha acuñado el término memoria activa para describir la capacidad del modelo de mantener y sintetizar datos entregados por el usuario durante días, semanas o incluso meses. En un video de lanzamiento, la investigadora Kavya Kopparapu explicó:
«Hemos invertido un enorme esfuerzo para que tu modelo recuerde lo que es importante para ti a lo largo del tiempo»
. Esta característica está pensada para potenciar asistentes personales que puedan ejecutar tareas complejas sin necesidad de repetir instrucciones en cada sesión.
El proceso detrás de la memoria activa se basa en una arquitectura de poda de contexto que prioriza la información relevante y descarta datos redundantes. La idea es similar a la forma en que nuestro cerebro guarda recuerdos clave y olvida los detalles superfluos: el modelo mantiene una “capa de recuerdo” que se actualiza tras cada interacción.
Implicaciones de precios y disponibilidad
El acceso a Muse Wonder se realiza mediante la Meta Model API. La tarificación es de $4.00 por millón de tokens de entrada y $20.00 por millón de tokens de salida. Estas cifras colocan a Muse Wonder en un rango de coste similar al de GPT‑6 Sol o Opus 5.5, lo que sugiere que Meta pretende competir directamente en el segmento empresarial de alto rendimiento.
Por su parte, Muse Wonder Full no está disponible a través de la API; su acceso está limitado a suscriptores de Muse Code, el paquete de desarrollo de Meta orientado a programadores que buscan generar código con IA. Esta estrategia de segmentación recuerda la práctica de OpenAI de reservar sus versiones más potentes para clientes premium.
- Precio de entrada: $4 USD por millón de tokens.
- Precio de salida: $20 USD por millón de tokens.
- Disponible vía API para Muse Wonder, pero no para Wonder Full.
- Wonder Full exclusivo para suscriptores de Muse Code.
Qué implica para desarrolladores e investigadores
Para los desarrolladores independientes, la llegada de Muse Wonder abre una alternativa competitiva a los modelos de OpenAI y Anthropic, especialmente en proyectos que requieren retención de información a largo plazo, como asistentes de productividad o plataformas de educación personalizada. La capacidad de “memoria activa” permite diseñar flujos de trabajo donde el agente IA mantiene el contexto de un usuario sin necesidad de almacenar datos sensibles en servidores externos.
Los investigadores, por su parte, disponen de un nuevo punto de referencia para evaluar técnicas de aprendizaje continuo. El hecho de que Meta haya incluido resultados en MemoryBench brinda una métrica estandarizada para comparar futuros avances en memoria de IA.
Sin embargo, la decisión de no abrir Wonder Full a la API plantea preguntas sobre la disponibilidad de datos de entrenamiento y la reproducibilidad de los experimentos. Hasta que Meta publique los detalles completos de la arquitectura y el conjunto de datos usado en el centro de datos Prometheus de Ohio, la comunidad deberá trabajar con la información pública limitada.
Muse Wonder representa un paso importante en la carrera por los modelos de frontera, combinando mayor capacidad de razonamiento con una memoria que se extiende más allá de la sesión actual. Su lanzamiento refuerza la posición de Meta en el mercado de IA de alto nivel y plantea nuevos desafíos tanto para usuarios que buscan soluciones robustas como para competidores que intentan igualar su nivel de desempeño.
Como señaló el propio blog de Meta:
«Juntos, marcan el siguiente escalón en nuestra escalera de escala y un salto importante hacia la superinteligencia personal»
. El resto del ecosistema observará cómo se traduce esa promesa en adopción real y en la evolución de la arquitectura de modelos de lenguaje.