

El fin de la nube: cómo montar un sistema de IA sin depender de nadie
La factura creciente de las API y el celo por la privacidad están empujando a desarrolladores y empresas a ejecutar modelos compactos en sus propios ordenadores. Analizamos el entramado técnico de esta silenciosa reconquista.
Cada vez que una consulta viaja a los servidores centralizados de OpenAI, Google o Anthropic, un contador invisible añade fracciones de centavo a la factura corporativa de miles de empresas. Para muchas startups y departamentos de tecnología, la cifra a fin de mes ha dejado de ser un coste operativo asumible para convertirse en una sangría insostenible. Mientras los gigantes de Silicon Valley insisten en que el futuro pertenece a modelos gigantescos accesibles únicamente mediante suscripción, una contrarrecogida técnica cobra fuerza desde abajo: la migración hacia modelos de lenguaje pequeños (SLM, por sus siglas en inglés) ejecutados íntegramente en local.
No estamos ante una simple moda de entusiastas del código abierto ni frente a un mero ejercicio académico. La necesidad imperativa de procesar información confidencial sin vulnerar normativas de privacidad, sumada a los problemas de latencia e interrupciones en los servicios en la nube, ha transformado el procesamiento local en una prioridad estratégica de primer orden.
La rebelión silenciosa contra el peaje de las suscripciones
Durante los primeros dos años de la fiebre actual por la inteligencia artificial, la narrativa oficial dictó que solo aquellos modelos con cientos de miles de millones de parámetros eran capaces de ofrecer respuestas razonables. Sin embargo, los avances recientes en la optimización de código y en la cuantización —una técnica que reduce la precisión matemática con la que opera el modelo para disminuir drásticamente el uso de memoria sin perder un rendimiento perceptible— han cambiado las reglas del juego.
Hoy en día, un modelo compacto diseñado para cumplir tareas concretas puede igualar, e incluso superar, a los gigantes de la nube en tareas especializadas de clasificación, extracción de datos o redacción técnica. La gran diferencia radica en que estos sistemas reducidos se ejecutan en un portátil moderno o en un servidor local sin enviar un solo byte fuera de la red de la empresa.
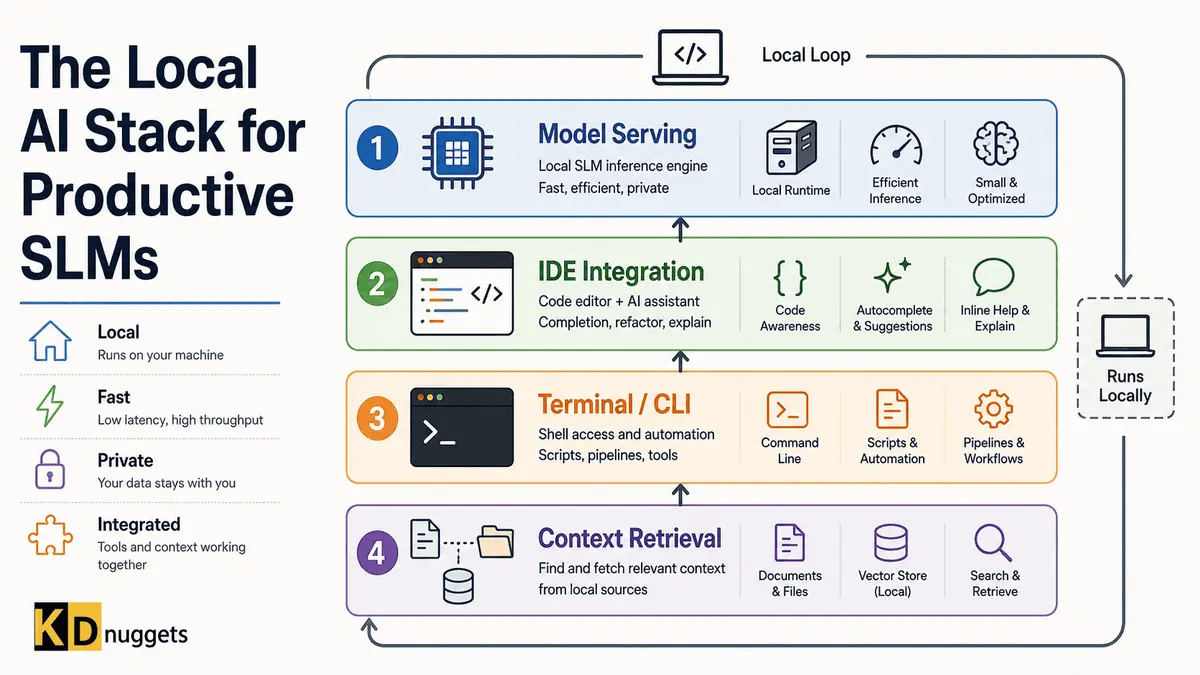
El verdadero reto técnico ya no reside en conseguir un modelo capaz, sino en articular un entramado de herramientas que le permita trabajar con datos propios de forma fluida. Tal como analiza una reveladora guía de arquitectura publicada por KDnuggets, estructurar una infraestructura local eficiente exige integrar distintas capas tecnológicas que antes las grandes plataformas enmascaraban tras una API propietaria.
Las capas invisibles de una infraestructura sin ataduras
Para conseguir que un modelo local entienda el contexto de una empresa y responda sin inventar información, la comunidad técnica ha estandarizado una arquitectura por capas que replica en local lo que antes requería infraestructura millonaria:
- Servidores de modelos localizados: Herramientas como Ollama, vLLM o LM Studio actúan como el motor principal. Gestionan la carga del modelo en la memoria de la tarjeta gráfica y optimizan las peticiones para que la respuesta sea casi instantánea.
- Almacenamiento vectorial privado: Soluciones de bases de datos como Chroma, Qdrant o LanceDB permiten convertir documentos internos, PDFs o bases de datos en vectores numéricos. Esto hace posible hacer búsquedas por significado directo sin exponer la información corporativa a terceros.
- Marcos de orquestación y consulta: Librerías como LangChain o LlamaIndex funcionan como el tejido conector, canalizando la pregunta del usuario, buscando la información relevante en la base de datos local y entregando ese contexto al modelo compacto.
Esta flexibilidad modular otorga a las empresas un poder del que carecían: si un modelo queda desfasado o aparece una alternativa más eficiente en la comunidad, se puede reemplazar en cuestión de minutos sin necesidad de rehacer toda la aplicación ni renegociar contratos de servicio.
La letra pequeña que los evangelistas del hardware prefieren omitir
A pesar del entusiasmo de la comunidad desarrolladora, la independencia total de la nube exige asumir compromisos técnicos notables. Mantener una pila de software local significa convertirse en el propio administrador del sistema: requiere gestionar la memoria RAM de la tarjeta gráfica, lidiar con incompatibilidades de controladores y aceptar que la ventana de contexto de los modelos más pequeños suele ser más limitada que la de un superordenador remoto.
Además, esta tendencia ha abierto una grieta de intereses en la propia industria tecnológica. Mientras los proveedores de la nube contemplan con preocupación una migración que reduce sus ingresos recurrentes por tokens consumidos, los grandes fabricantes de procesadores y tarjetas gráficas celebran la tendencia. La inclusión acelerada de unidades de procesamiento neuronal (NPU) en la última generación de portátiles no responde a una casualidad, sino al deseo de vender chips capaces de mover este nuevo software sin despeinarse.
💡 El panorama general: ¿Cómo nos afecta esto?
La consolidación de infraestructuras locales con modelos compactos marca el fin del periodo de candidez respecto a la nube centralizada. Durante años, el modelo de software como servicio (SaaS) acostumbró al mercado a externalizar la infraestructura. Sin embargo, cuando los costes directos se disparan y la propiedad intelectual se convierte en el activo más valioso de una organización, el procesamiento descentralizado deja de ser un experimento para convertirse en un escudo defensivo.
A nivel profesional y laboral, este cambio de paradigma redefinirá el perfil técnico demandado. Los desarrolladores e ingenieros ya no podrán limitarse a conectar enlaces de aplicaciones de terceros; deberán dominar conceptos de optimización de memoria, ajuste de modelos reducidos y eficiencia energética. Las organizaciones que aprendan a implantar estos sistemas locales obtendrán una ventaja competitiva determinante: velocidad, coste predecible y privacidad absoluta.
A corto y medio plazo, el mercado no avanzará hacia una sustitución drástica, sino hacia una coexistencia pragmática. Las tareas cotidianas, el tratamiento de datos sensibles y las automatizaciones internas se ejecutarán directamente en el chip de nuestros dispositivos personales. La nube, por su parte, quedará reservada exclusivamente para aquellos problemas matemáticos o analíticos tan colosales que superen las capacidades del hardware local. La verdadera revolución de la inteligencia artificial no consistía en alquilar el cerebro de otro, sino en aprender a ejecutar el nuestro.
