

Sarvam AI desafía a OpenAI y Deepgram con un modelo de voz para 22 idiomas indios
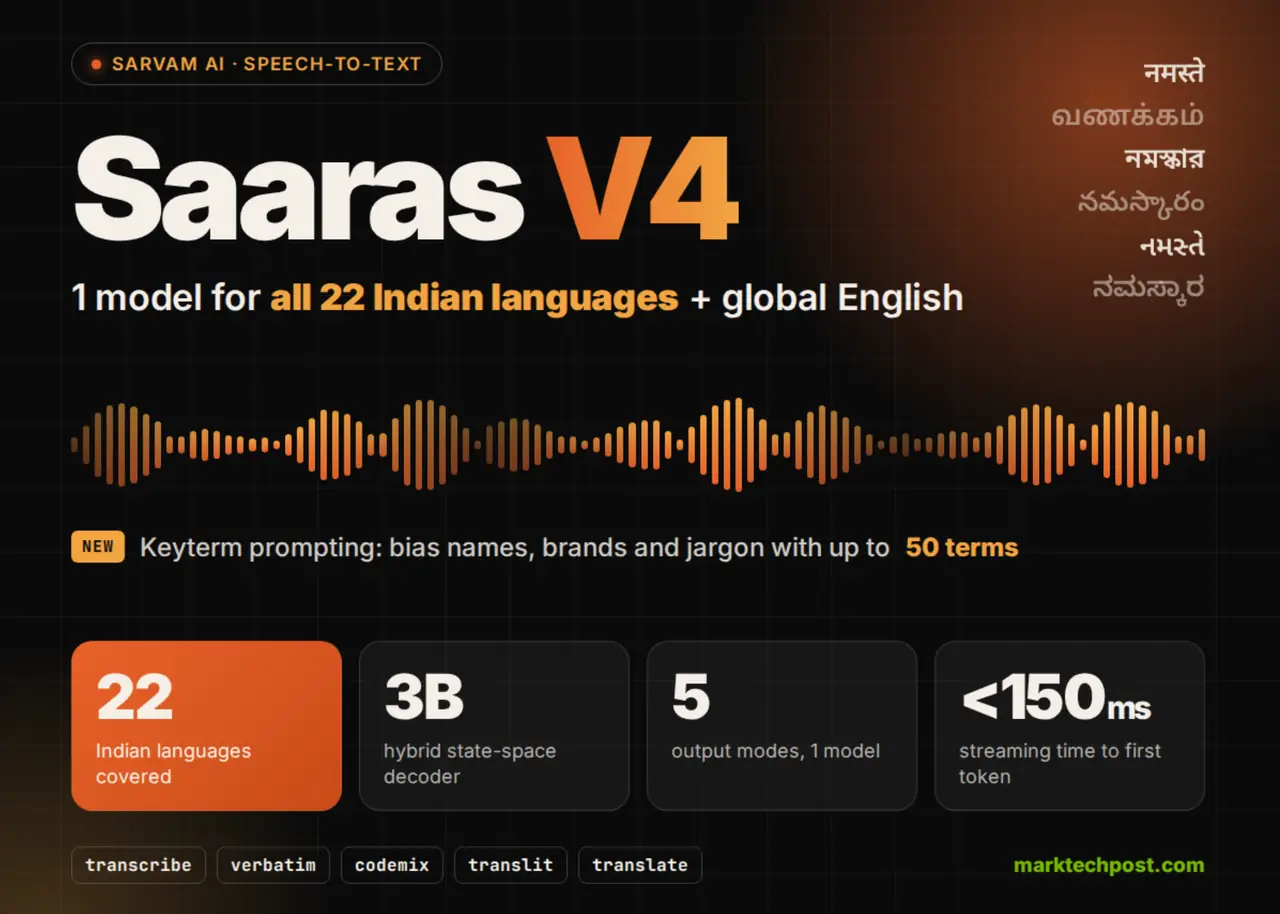
La startup india presenta Saaras V4, una arquitectura de reconocimiento de voz basada en un modelo híbrido de 3.000 millones de parámetros diseñado para operar en entornos acústicos complejos y múltiples dialectos.
El reconocimiento de voz en mercados con alta diversidad lingüística presenta desafíos técnicos que los modelos globales generalistas rara vez resuelven con precisión. Para abordar esta brecha, la firma india Sarvam AI ha presentado Saaras V4, la cuarta generación de su sistema de conversión de voz a texto (STT). El modelo ofrece cobertura para los 22 idiomas oficiales reconocidos en la Constitución de la India, además de soporte para inglés con acentos globales e indios.
Disponible de forma inmediata a través de la API comercial de la compañía bajo el identificador model="saaras:v4", el sistema no se ofrece por ahora en modalidad de código abierto. A diferencia de las iteraciones anteriores, donde la empresa proporcionaba guías de despliegue en Amazon SageMaker, la documentación oficial actual para autoalojamiento se mantiene restringida a la versión v3, dejando a la versión V4 como un servicio gestionado exclusivo en la nube del proveedor.
Una arquitectura híbrida que optimiza el procesamiento de audio extenso
Desde el punto de vista arquitectónico, Saaras V4 emplea un esquema de codificador-decodificador optimizado para secuencias de audio de larga duración. El flujo de trabajo comienza en un codificador de audio que transforma las ondas sonoras en vectores de características (embeddings) que capturan matices fonéticos y acústicos. A continuación, un módulo adaptador de submuestreo temporal reduce la longitud de la secuencia vectorial antes de proyectarla en el espacio de representación del modelo de lenguaje.
Esta reducción intermedia resulta crítica para evitar el agotamiento de la memoria en la ventana de contexto durante grabaciones extensas. El componente decodificador es Sarvam-3B, un modelo de lenguaje híbrido basado en arquitecturas de espacio de estados (SSM) de 3.000 millones de parámetros, desarrollado y entrenado internamente desde cero. Sarvam-3B procesa las características del audio junto con una instrucción de texto inicial (prompt) y genera la transcripción de manera autorregresiva, reinyectando cada token generado para predecir el siguiente.
Métricas de precisión y rendimiento en entornos ruidosos
Según los datos distribuidos por Sarvam AI, el modelo ha alcanzado las tasas de error de palabra (WER, por sus siglas en inglés) más bajas en conjuntos de evaluación estándar. En inglés, el modelo fue evaluado frente a siete referencias, seis de ellas pertenecientes al panel de control Open ASR Leaderboard de Hugging Face (AMI, GigaSpeech, LibriSpeech clean, LibriSpeech otros, SPGISpeech y VoxPopuli) y una séptima correspondiente a Svarah, desarrollada por el grupo AI4Bharat para evaluar acentos indios.
En la evaluación multilíngüe sobre el benchmark Vistaar, que abarca 10 lenguas locales, la empresa utilizó la métrica tradicional WER junto con la variante LLM-WER. Este segundo indicador utiliza un modelo de lenguaje para realizar una validación semántica que ignora discrepancias menores de ortografía o formato ortográfico en escrituras complejas (como el devanagari o el bengalí) siempre que el significado original se conserve intacto.
En pruebas sobre el conjunto de datos Kathbath Noisy —diseñado con grabaciones sujetas a compresión severa, recorte de señal y alto ruido de fondo—, Saaras V4 registró una tasa de error semántico (LLM-WER) inferior a la mitad de la obtenida por competidores comerciales como Deepgram Nova-3 o las herramientas de transcripción de GPT-4o. En cuanto a la identificación automática de idioma (LID), el sistema reportó una tasa de error del 2,9% en los diez idiomas indios principales sobre el corpus IndicVoices, y del 5,22% al extender la prueba a la totalidad de las 22 lenguas. Es necesario recalcar que todas las métricas publicadas provienen de evaluaciones internas del desarrollador y aún no cuentan con réplicas independientes de laboratorios terceros.
Cinco modos de salida e inyección de términos clave
Para evitar canalizaciones de procesamiento secundario (post-processing) que suelen acumular errores en las aplicaciones finales, Saaras V4 integra la capacidad de dar formato al texto directamente durante la inferencia. Mediante la configuración del parámetro mode en la llamada a la API, los desarrolladores pueden alternar entre cinco representaciones de salida distintas:
Parámetro mode | Comportamiento del modelo |
|---|---|
transcribe | Transcripción estándar en la escritura nativa con números y fechas normalizados. |
verbatim | Transcripción literal que conserva muletillas, pausas y números hablados sin normalizar. |
codemix | Transcripción en escritura nativa que mantiene los términos en inglés en alfabeto latino. |
translit | Transliteración completa del enunciado al alfabeto latino. |
translate | Traducción directa al inglés con normalización numérica integrada. |
Junto a estos modos de operación, el modelo introduce la funcionalidad de sesgado por términos clave (keyterm prompting). A través del parámetro keyterms, los desarrolladores pueden enviar una lista en formato JSON de hasta 50 términos específicos (con un límite de 64 caracteres por palabra). Esto permite orientar al modelo para reconozca correctamente nombres de marcas locales, jerga financiera o nombres propios sin alterar la coherencia sintáctica.
En las pruebas sobre el benchmark especializado IndicContextEval, Saaras V4 alcanzó una tasa de error WER del 16,03% bajo el escenario L5 de inyección de términos clave, la cifra más baja registrada en dicha evaluación técnica hasta la fecha.
El reto del despliegue en entornos comerciales de alta concurrencia
La estrategia de Sarvam AI refleja la creciente demanda de modelos de voz adaptados a patrones lingüísticos reales, donde la alternancia de código (code-switching o mezcla de inglés con lenguas locales) es la norma en la atención telefónica y los servicios financieros. Al integrar la normalización, la traducción y el cambio de alfabeto dentro del propio decodificador de 3B parámetros, la arquitectura reduce la latencia total del pipeline al eliminar llamadas intermedias a modelos de traducción o scripts de limpieza de texto.
Sin embargo, la decisión de mantener Saaras V4 como un modelo cerrado accesible únicamente por API plantea interrogantes sobre la flexibilidad de costes para empresas de gran volumen. Aunque la arquitectura basada en SSM (state-space models) ofrece teóricamente un escalado de memoria lineal frente al coste cuadrático de la atención estándar en Transformers, los desarrolladores dependerán por completo de la infraestructura gestionada de Sarvam AI hasta que se publiquen las guías de despliegue privado en la nube.
