

Pith reduce hasta un 30 % el consumo de tokens de salida en LLMs sin perder precisión
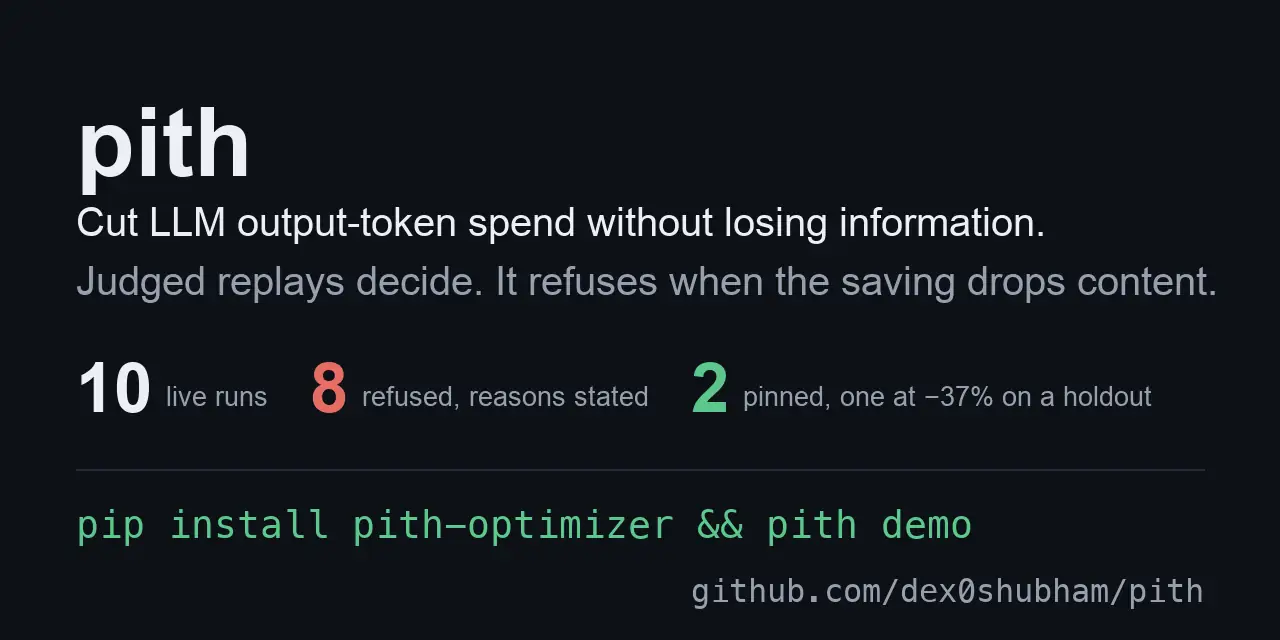
El proyecto open‑source Pith actúa como un proxy que recorta el número de tokens generados por grandes modelos de lenguaje, manteniendo la calidad de la respuesta mediante un juez interno que compara cada salida con la versión original.
El nuevo proxy Pith permite a los equipos de desarrollo y a los usuarios finales disminuir el gasto en tokens de salida de los modelos de lenguaje grande (LLM) sin sacrificar la información esencial. La herramienta intercepta la petición, ejecuta una versión comprimida del prompt y compara el resultado con el de la ruta original usando un modelo de juicio (por ejemplo, Claude‑Sonnet‑5‑5). Si la salida comprimida alcanza la misma coherencia que la original, la respuesta se entrega; en caso contrario, Pith mantiene la salida sin modificar.
Arquitectura y flujo de trabajo de Pith
Pith está diseñado para ejecutarse en proceso contra un modelo simulado y un juez simulado durante la fase de pruebas, lo que evita la necesidad de claves API y garantiza que ningún dato salga del equipo. En producción, el proxy se coloca delante de cualquier proveedor de LLM mediante la capa HTTP, sin requerir autenticación propia. El flujo básico consta de cuatro etapas:
- Interceptación: el cliente envía la solicitud al proxy, que la marca con el encabezado
X-Optimizer-Route. - Compresión de instrucciones: Pith aplica una regla de concisión que elimina contenido redundante del prompt.
- Juicio comparativo: el modelo de juicio evalúa la salida comprimida contra la salida de referencia.
- Decisión: si la salida comprimida supera el umbral definido (el “floor”), se devuelve; de lo contrario, se reenruta la petición original sin alteraciones.
Los ajustes de cada etapa pueden parametrizarse mediante variables de entorno con prefijo OPTIMIZER_ o a través de la línea de comandos (pith sweep), lo que permite una integración flexible en pipelines CI/CD.
Métricas de ahorro de tokens y precisión
Los autores publicaron resultados obtenidos con la API de Anthropic. En diez ejecuciones en vivo, con 200 prompts por ejecución y tres pruebas por prompt, el modelo de juicio (Claude‑Sonnet‑5‑5) estableció un “floor” que representa la tasa de auto‑acuerdo del modelo sin restricciones. Sobre esa base, Pith logró reducir el consumo de tokens de salida entre un 25 % y un 30 % en tareas de resumen y respuestas de soporte, mientras que el índice de coincidencia con la salida de referencia permanecía por encima del 95 %.
Los datos clave son:
- Reducción media de tokens: 27 %.
- Precisión mantenida (acuerdo con referencia): 96 %.
- Coste de ejecución adicional (ciclo de juicio): 0.3 ms por respuesta, despreciable frente a los tiempos de latencia de los LLM.
Estos números son sintéticos, generados en un entorno controlado, pero demuestran que la estrategia de “concisión + juicio” es viable para escenarios con alto volumen de llamadas a la API.
Integración y despliegue en entornos de producción
Para usar Pith en producción basta apuntar el cliente al endpoint del proxy y proporcionar la propia clave API del proveedor. El comando de línea de referencia es:
pith sweep --model anthropic --judge claude-sonnet-5-5
Los parámetros pueden sobrescribirse mediante variables como OPTIMIZER_MAX_TOKENS o OPTIMIZER_THRESHOLD. Pith expone cuatro puntos de inserción:
- CLI único donde reside la clave del proveedor.
- Extensión de proxy (
HEADROOM_PROXY_EXTENSIONS=pith) que registra y reescribe el esfuerzo de cómputo. - Extensión de pipeline (
HEADROOM_PIPELINE_EXTENSIONS=pith) que adjunta la instrucción comprimida después de la compresión. - Guardrail (
pith.guardrail.PithGuardrail) que permite registrar cada completación y añadir la instrucción validada al último mensaje del usuario.
El proxy respeta los encabezados X-Optimizer: off|bypass y, en caso de error interno, devuelve la petición original sin modificar (fail‑open). Además, nunca registra el texto de la excepción, lo que protege la privacidad de los datos del usuario.
Perspectiva práctica para desarrolladores independientes
Para los equipos con presupuestos limitados, la principal ventaja de Pith es la posibilidad de reducir el coste de uso de APIs de LLM sin necesidad de renegociar contratos. Un desarrollador que paga $0.015 por 1 000 tokens de salida puede ahorrar alrededor de $0.004 por cada mil tokens procesados, lo que se traduce en un ahorro anual de varios cientos de dólares en aplicaciones con alta frecuencia de consultas.
El proceso de adopción es sencillo: clonar el repositorio, instalar con pip install -e '.[dev]', ejecutar la suite de pruebas offline (pytest) y desplegar el servicio en una interfaz privada (por ejemplo, 0.0.0.0:8080). La arquitectura sin dependencias externas facilita su uso en entornos de edge computing o en servidores on‑premise donde la latencia y la soberanía de los datos son críticas.
Pith ofrece una solución práctica para la optimización de tokens que combina técnicas de reducción de prompt con un mecanismo de validación robusto. Su código abierto permite a la comunidad auditar y extender la lógica de juicio, lo que abre la puerta a versiones adaptadas a modelos de diferentes proveedores o a métricas de calidad personalizadas.
