

Por qué los evaluadores integrados no garantizan confianza ni estandarización en IA
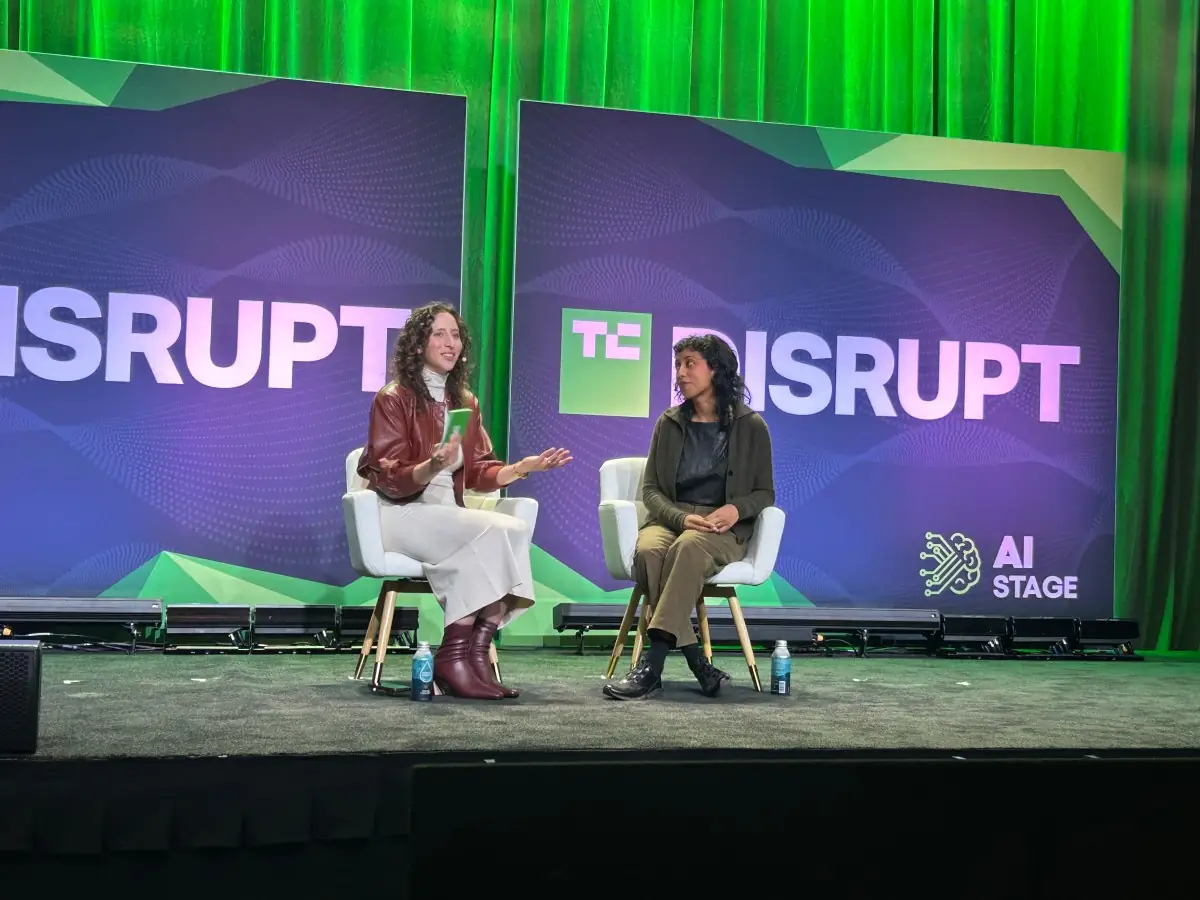
Irene Solaiman, directora de política de Hugging Face, advierte que los benchmarks actuales carecen de reproducibilidad y de criterios uniformes, lo que complica la adopción de evaluadores internos en los laboratorios de IA.
Hugging Face ha puesto en la palestra la fragilidad de los benchmarks de IA, señalando que la reproducibilidad y la falta de estándares hacen que los evaluadores integrados no sean la solución sencilla que muchos esperan.
La crisis de reproducibilidad en los benchmarks de IA
Desde los primeros concursos de visión por computadora, los laboratorios han utilizado pruebas estandarizadas para demostrar que su modelo supera a la competencia. Sin embargo, según Solaiman, “
La confianza es un término muy cargado; para confiar en un resultado, primero hay que poder reproducirlo y disponer del acceso necesario al modelo, y ahí es donde los pesos abiertos juegan un papel decisivo.
” La ausencia de open weights impide que terceros reproduzcan métricas con la exactitud requerida, lo que debilita la credibilidad de los resultados publicados.
Evaluadores integrados — promesas y limitaciones reales
La idea de colocar a observadores “neutrales” dentro de las organizaciones de IA surgió como respuesta a incidentes de seguridad que han sacudido la confianza pública. Empresas como Anthropic contrataron a consultoras externas (por ejemplo, Accenture) para actuar como evaluadores. El enfoque generó críticas porque la neutralidad de una firma de consultoría que también vende servicios de IA es cuestionable.
Solaiman subraya que “
El ecosistema de evaluadores embebidos necesita una estandarización mucho mayor; no basta con declarar neutralidad, hay que definir qué tareas y qué métricas califican a un evaluador como eficaz.
” En la práctica, la falta de criterios claros lleva a que diferentes equipos utilicen pruebas incompatibles, dificultando comparaciones significativas.
El papel de los harness y agentes en la valoración de modelos
El foco de la evaluación está migrando del modelo puro a todo el sistema que lo rodea: el harness (interfaz de acceso) y el agentic eval (comportamiento del agente que envuelve al modelo). Un modelo de menor capacidad puede superar a uno de última generación si se combina con un harness optimizado que reduce latencia y mejora la gestión del contexto.
Solaiman advierte que “
Los evals agenticos son realmente difíciles y costosos; disponemos de muchos benchmarks para modelos, pero pocos para harnesses, y estamos trabajando en mejores evaluaciones holísticas.
” Esta observación revela que la comunidad aún no dispone de métricas robustas para medir la interacción entre modelo y entorno de ejecución.
Implicaciones para desarrolladores y la industria
Para los equipos de desarrollo, la ausencia de un marco de referencia unificado significa que deben invertir recursos considerables en reproducir pruebas internas y validar sus resultados contra múltiples fuentes. La dependencia de hardware especializado y de datos propietarios eleva los costes y limita la participación de startups con presupuestos modestos.
Desde la perspectiva del mercado, la falta de confianza en los benchmarks debilita la capacidad de los inversores para comparar ofertas de manera objetiva, lo que puede ralentizar la adopción de nuevas arquitecturas y perpetuar la hegemonía de los grandes jugadores que disponen de infraestructura propia para ejecutar pruebas a gran escala.
la industria necesita un esfuerzo coordinado que combine la apertura de pesos, la definición de métricas para harnesses y agentes, y la creación de protocolos de evaluación auditables. Sólo así los evaluadores integrados podrán cumplir su promesa de aportar una capa de seguridad y transparencia sin convertirse en un parche temporal.
