

El truco técnico para reducir el consumo de la IA a la mitad
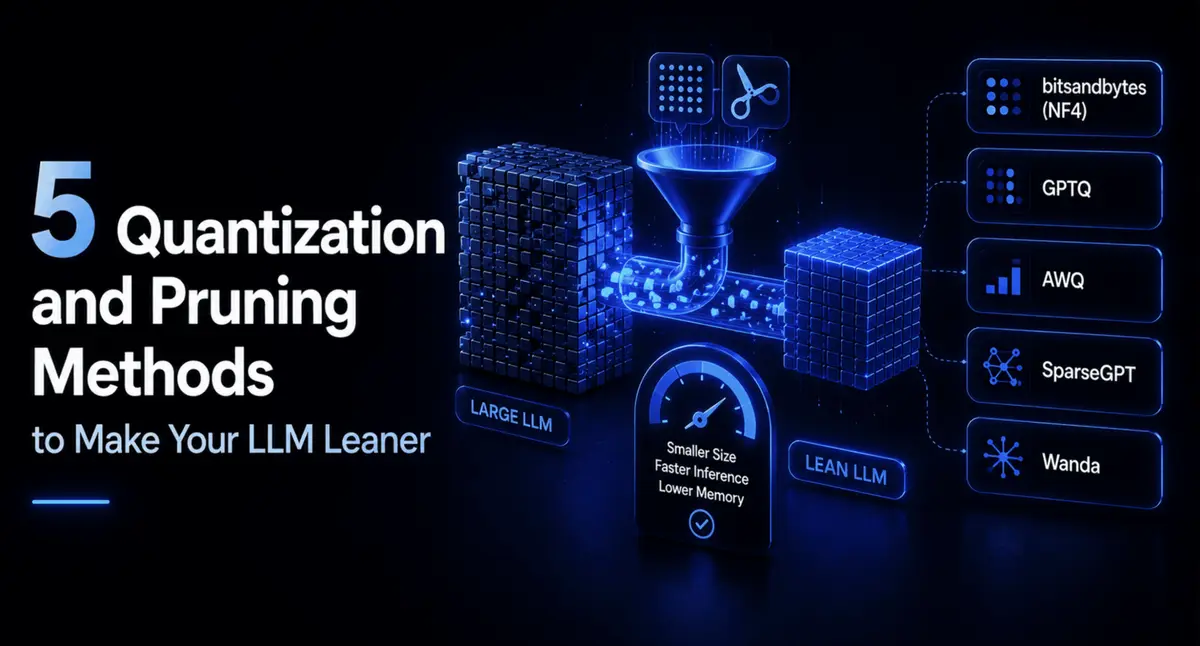
Las técnicas de cuantización y podado neuronal se han convertido en el pilar silencioso de las tecnológicas para recortar costes millonarios y llevar asistentes inteligentes directamente a tu ordenador sin pasar por la nube.
Desplegar un modelo de lenguaje de última generación no solo es una hazaña de la ingeniería moderna; es también un pozo sin fondo de recursos financieros y energéticos. Detrás de las vistosas demostraciones de chatbots y asistentes virtuales existe una cruda realidad que los gigantes tecnológicos prefieren no airear en sus presentaciones principales: mantener activas estas arquitecturas gigantescas en servidores en la nube representa una factura millonaria insostenible a largo plazo. En esta carrera desenfrenada por la eficiencia, la industria ha dejado de obsesionarse únicamente con construir modelos cada vez más grandes para enfocarse en un objetivo igual de crucial: aprender a encogerlos violentamente sin destruir su capacidad intelectual.
La fiebre por la eficiencia: recortar sin destruir la inteligencia
Hasta hace poco, el paradigma dominante en la inteligencia artificial generativa era simple y cuantitativo: más parámetros equivalían a una mayor inteligencia. Sin embargo, este enfoque ha chocado de frente contra las limitaciones de la infraestructura física y el suministro eléctrico de los centros de datos globales. Para solucionar esta crisis de escalabilidad, los ingenieros recurren cada vez más a dos técnicas esenciales que están transformando la producción de IA: la cuantización (reducir la precisión numérica con la que se almacenan los datos) y el podado (eliminar conexiones neuronales superfluas).
Omitir estos procesos en el ciclo de despliegue no es solo un descuido técnico, sino un error financiero de gran calado. Según un detallado análisis publicado en el portal especializado KDnuggets, operar modelos masivos en producción sin aplicar técnicas de compresión duplica o triplica la latencia de respuesta y multiplica de forma desorbitada los costes de almacenamiento en memoria VRAM. La diferencia entre implementar estas optimizaciones o ignorarlas representa la frontera entre un servicio rentable y una infraestructura deficitaria.
Cuantización: el arte de hablar en números más pequeños
Para comprender la cuantización sin perderse en el lenguaje matemático, basta con imaginar una imagen digital en altísima resolución. Si reducimos la paleta de colores de 16 millones de tonos a solo unos miles, la foto pesará infinitamente menos y la gran mayoría de las personas apenas notará la diferencia a simple vista. En los modelos de lenguaje ocurre algo idéntico: originalmente, las conexiones internas de un modelo se guardan como números decimales de alta precisión (usualmente de 16 bits).
La cuantización convierte estos valores complejos en representaciones de 8 bits o incluso de 4 bits. Al reducir este empaquetado numérico, la memoria requerida para cargar el modelo se desploma en un 50% a un 75%. Métodos modernos de cuantización permiten que un modelo que antes requería un servidor industrial con múltiples tarjetas gráficas de última generación pase a ejecutarse holgadamente en la memoria de un ordenador portátil estándar o en un smartphone de gama alta, manteniendo intacta cerca del 95% de su precisión original.
Podado neuronal: retirar las vigas innecesarias del edificio
Si la cuantización se encarga de reducir la precisión de la información, el podado (conocido en inglés como pruning) actúa como un bisturí quirúrgico sobre la estructura misma del modelo. En una red neuronal masiva con cientos de miles de millones de parámetros, no todas las conexiones participan por igual en la toma de decisiones. De hecho, un porcentaje considerable de estas conexiones apenas influye en las respuestas finales del sistema.
El podado analiza de forma minuciosa la importancia relativa de cada «peso» o conexión neuronal e identifica cuáles son irrelevantes para eliminarlas por completo. Al suprimir estas conexiones superfluas, la arquitectura resultante no solo ocupa menos espacio en disco, sino que requiere sustancialmente menos cálculos matemáticos por cada palabra generada. El resultado es una aceleración drástica en el tiempo de respuesta y una reducción considerable del calor y la energía consumida por el hardware subyacente.
El cálculo silencioso detrás del cambio de estrategia
¿Por qué las grandes empresas de tecnología están impulsando tan activamente estas tecnologías de compresión precisamente ahora? La respuesta no reside únicamente en un altruista deseo de democratizar la tecnología ni en una repentina preocupación medioambiental. Existe una razón mucho más apremiante: el cuello de botella en la fabricación de chips especializados y la crisis de espacio en los centros de datos.
Empresas como Meta, Microsoft y Google son conscientes de que la capacidad de producción de procesadores avanzados está saturada y los costes energéticos están amenazando los márgenes de beneficio de sus servicios en la nube. Al liberar modelos optimizados que pueden ejecutarse localmente en el dispositivo del usuario final, las compañías consiguen desplazar el gasto computacional desde sus costosos servidores hacia los procesadores (NPU y GPU) de los clientes finales. Es una jugada maestra de arquitectura financiera disfrazada de optimización técnica.
💡 El panorama general: ¿Cómo nos afecta esto?
La transición masiva hacia modelos de inteligencia artificial más ligeros y comprimidos marca un punto de inflexión decisivo en nuestra relación con la tecnología diaria. Durante los últimos años, dependíamos de forma absoluta de una conexión permanente a internet y de la infraestructura centralizada de los gigantes de Silicon Valley para utilizar herramientas inteligentes avanzadas. La consolidación de la cuantización y el podado rompe esta dependencia, abriendo las puertas a una era de IA local, privada y verdaderamente descentralizada.
A nivel de privacidad y seguridad de datos, este cambio representa una victoria monumental para los usuarios y las empresas con normativas estrictas de confidencialidad. Al poder ejecutar asistentes complejos directamente en un ordenador portátil o dispositivo médico sin enviar un solo byte a la nube, la fuga de datos sensibles se vuelve prácticamente imposible. Asimismo, reduce la brecha digital en regiones con conectividad deficiente, permitiendo utilizar herramientas de diagnóstico o asistencia educativa sin necesidad de banda ancha.
Por otro lado, desde el punto de vista económico y laboral, esta transformación redefinirá las competencias exigidas a los desarrolladores del mañana. Ya no bastará con saber conectar una API remota mediante un par de líneas de código; el valor estratégico residirá en la capacidad de optimizar, cuantizar y desplegar modelos eficientes en hardware limitado. La eficiencia computacional ha dejado de ser un lujo secundario para convertirse en el pilar central sobre el que se edificará el futuro de la inteligencia artificial.
